Programmazione IA locale su una GPU da 16 GB: Strata, OpenCode e Qwen3.8
Table of Contents
Un agente di programmazione locale su una GPU da 16 GB è pratico per attività di sviluppo delimitate. Strata e OpenCode combinano inferenza locale, modifica dei file, comandi shell ed esecuzione dei test. Un’esecuzione riportata di Qwen3.8-Flash-Next su una RTX 4060 Ti ha completato un’applicazione, modifiche successive e un prototipo di gioco di corse senza chiamate di inferenza a pagamento.
Sostituire un abbonamento richiede un test più ampio. I risultati pubblicati mostrano una configurazione funzionante su una macchina. Non dimostrano la parità con servizi di programmazione a pagamento tra linguaggi, repository o attività di debug difficili. L’hardware include anche 64 GB di memoria di sistema, che contiene gran parte del modello.
Punti chiave
- 16 GB indica la memoria della GPU, non la memoria totale richiesta dalla configurazione riportata.
- Il riuso dei prompt conta, perché gli agenti di programmazione inviano più volte cronologie di conversazione sovrapposte.
- Il ragionamento richiede un budget per lasciare spazio a codice e chiamate agli strumenti.
- I test generati superati sono solo una prova parziale, mentre Docker e il gameplay richiedono controlli separati.
- La spesa API pari a zero esclude i costi di possesso, l’elettricità e il tempo di manutenzione.
Prerequisiti: Un computer compatibile, spazio libero sufficiente per il modello scelto, Git, Node.js con npm e familiarità con gli strumenti del terminale. Abbina la configurazione IQ3_S riportata a 64 GB di RAM. Usa l’installer Strata corrente per controllare altre configurazioni.
Tempo e difficoltà: Intermedio. Dedica tempo ai download dei modelli grandi e all’installazione prima di valutare la velocità di completamento. I tempi riportati escludono la preparazione.
Configurazione testata
| Componente | Configurazione riportata |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 GB VRAM |
| CPU | Intel Core i5-11600K |
| Memoria di sistema | 64 GB RAM |
| Archiviazione | SSD NVMe |
| Modello | Qwen3.8-Flash-Next, MoE 125B, IQ3_S |
| Motore di inferenza | Strata |
| Agente di programmazione | OpenCode |
| Contesto configurato | 65.536 token |
| Limite di output configurato | 16.384 token |
La configurazione e i risultati pubblicati da NetworkCoder forniscono questi valori. Il repository di test riporta il caricamento di 46.84GiB di pesi degli esperti in 28 secondi, con 4.431 esperti che occupano 8.45GiB di memoria GPU. Queste misure descrivono l’esecuzione testata, non un’allocazione garantita con un’altra versione del motore.
La compatibilità corrente è più ampia di questo test. Alla verifica del 6 ottobre 2026, il progetto Strata documenta alcune schede NVIDIA e AMD con almeno 12 GB di VRAM, oltre a modelli più piccoli per sistemi con 32 GB di RAM. Queste opzioni non riproducono l’esperimento con GPU da 16 GB, 64 GB di RAM e IQ3_S. Controlla GPU, variante del modello e supporto del runtime prima di acquistare hardware.
Dove risiede il modello
Una miscela di esperti, o MoE, attiva un sottoinsieme delle reti esperte del modello per ogni token. Questo riduce il calcolo attivo rispetto all’uso di tutti i parametri a ogni passaggio. I pesi restanti richiedono comunque spazio e un percorso verso il calcolo.
L’esecuzione ibrida di Strata mantiene sulla GPU gli esperti usati spesso e conserva l’insieme degli esperti nella RAM di sistema. La CPU calcola in sede gli esperti non memorizzati nella cache, mentre la GPU gestisce quelli in cache. Lo spazio di archiviazione contiene anche i file del modello e i dati di ricerca. Il sistema non inserisce l’intero modello 125B in 16 GB di VRAM.
La memoria GPU ha usi concorrenti. Le allocazioni del runtime, lo stato dell’attenzione e la cache degli esperti condividono una risorsa limitata. Più spazio per il contesto cambia la capacità residua della cache degli esperti. Le versioni correnti di Strata supportano anche lo streaming della cache KV, quindi il posizionamento esatto differisce da una configurazione precedente. Consulta la documentazione tecnica per la tua versione del motore.
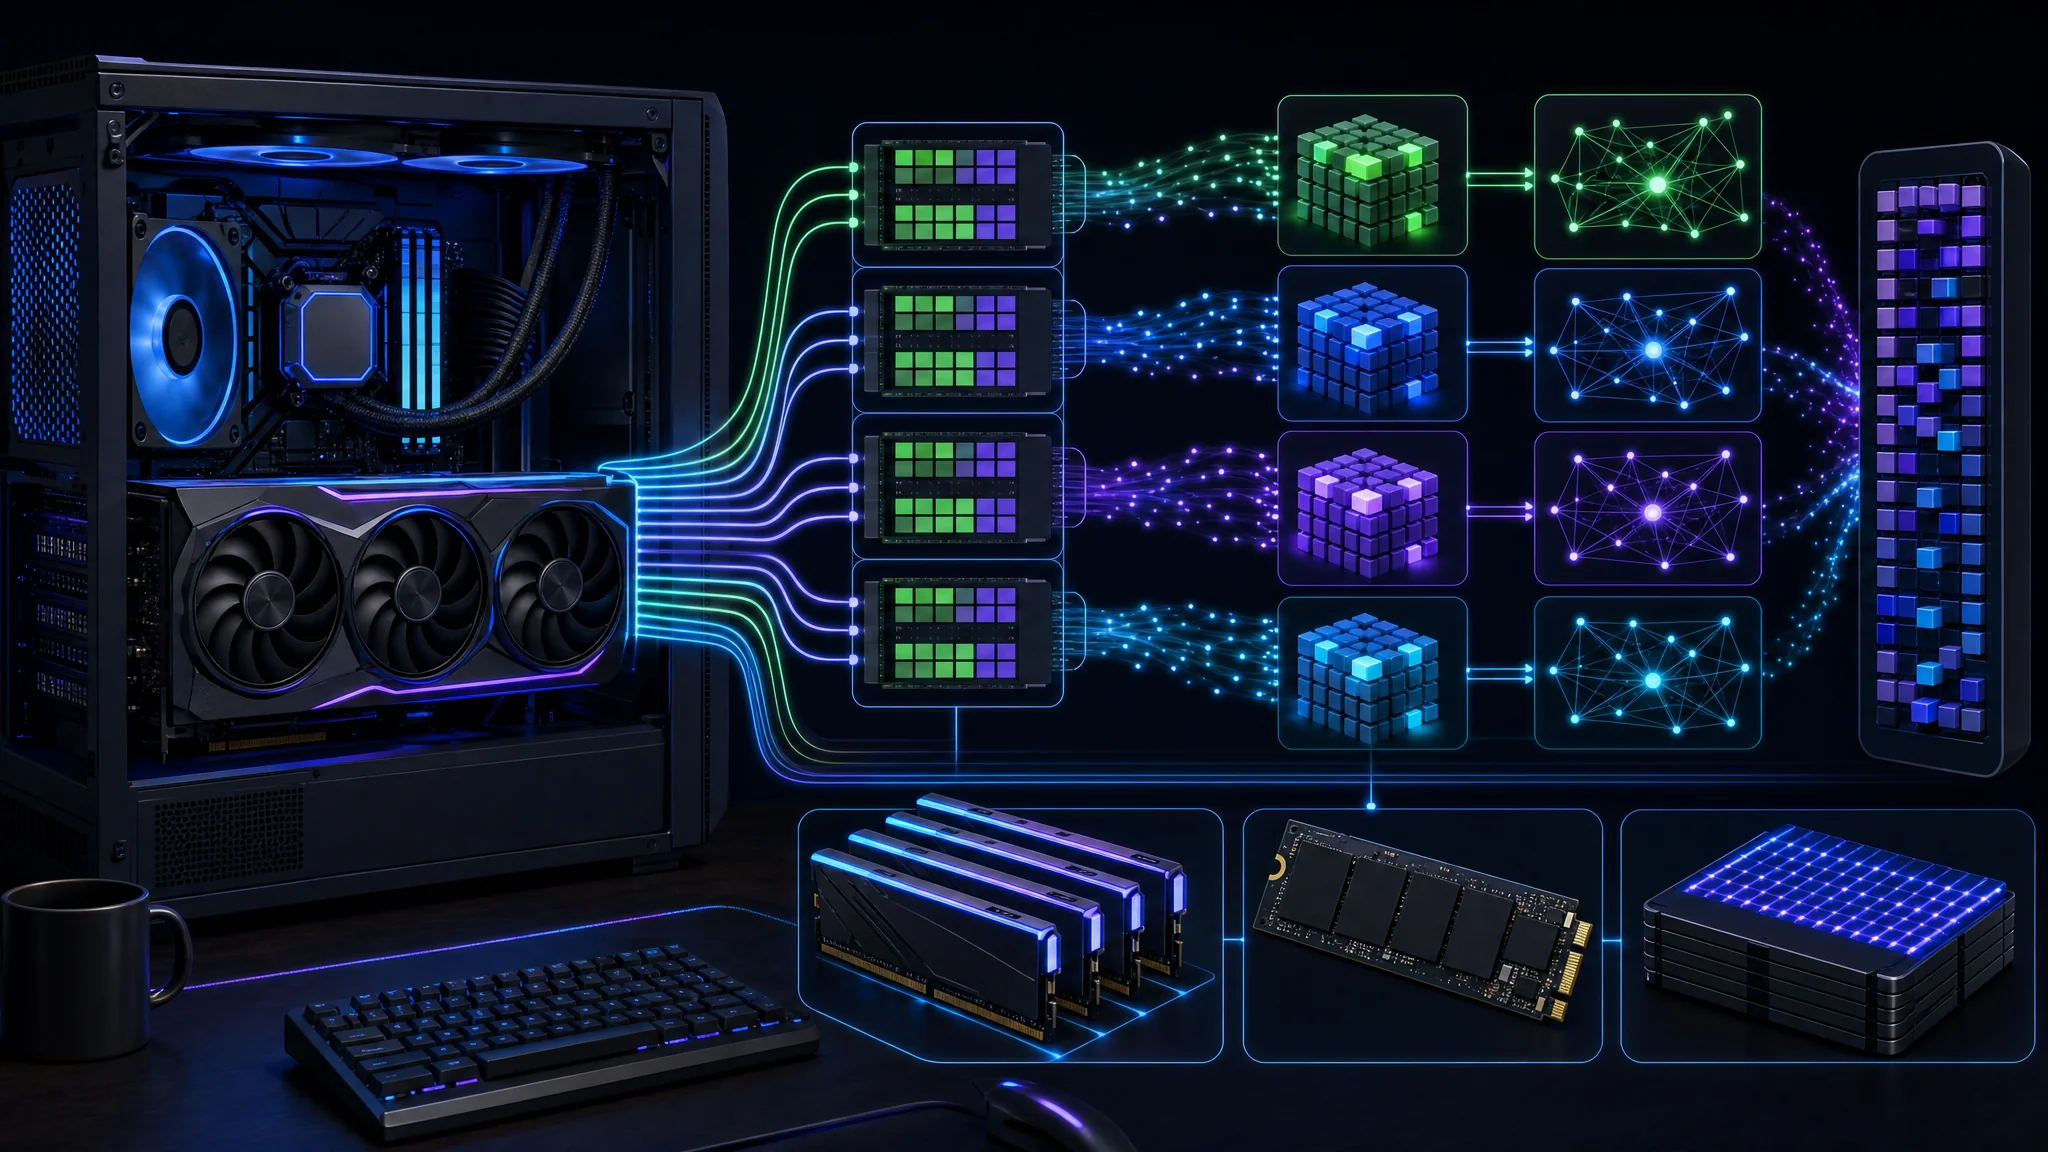
The GPU is one part of the inference system, alongside CPU execution, system RAM, and storage
Il riuso dei prompt cambia la velocità
Un agente di programmazione esegue un ciclo: legge l’attività, richiede un’azione a uno strumento, riceve il risultato e decide l’azione seguente. Contenuti dei file, errori e output dei test si accumulano nella conversazione. Gli agenti compattano o selezionano anche il contesto, quindi non tutte le implementazioni inviano per sempre la cronologia completa invariata.
Il prefill elabora i token di input prima della generazione. Il decode produce la risposta. Un sistema con decode veloce ma prefill ripetuto lento ti fa aspettare tra le chiamate agli strumenti.
Il tempo riportato per 44K token usava il riuso del prefisso. Strata riutilizzava contenuti della conversazione già elaborati, con il prompt in crescita pronto in circa uno o tre secondi. È un’indicazione utile per una sessione agente continua. Non dimostra l’elaborazione da zero di 44.000 token completamente nuovi in un secondo.
| Misurazione | Cosa registrare |
|---|---|
| Prompt freddo | Tempo per nuovo contenuto senza stato di prefisso riutilizzabile |
| Continuazione calda | Tempo dopo aver aggiunto il risultato di uno strumento al contesto esistente |
| Velocità di generazione | Token al secondo durante la risposta |
| Durata dell’attività | Pianificazione, generazione, strumenti, test e tentativi insieme |
Due cache hanno scopi diversi. La cache degli esperti mantiene i pesi usati spesso vicino al calcolo GPU. Il riuso del prefisso evita di ripetere il lavoro sugli input precedenti. Un’elevata percentuale di riscontri della cache degli esperti non dimostra un riscontro della cache dei prompt.
Cosa hanno dimostrato le attività
| Attività | Tempo riportato | Risultato riportato |
|---|---|---|
| Creare un task manager | 3m 38s | API Express, interfaccia, test 5/5 |
| Correggere la modifica e aggiungere date | 4m 58s | Modifiche completate, test 6/6 |
| Aggiungere import/export e packaging | 3m 48s | Test 7/7, build Docker non verificata |
| Gioco di corse, primo tentativo | 6m 35s | Output esaurito durante il ragionamento, nessun codice |
| Gioco di corse, nuovo tentativo con budget | 4m 51s | Gioco generato, sintassi JavaScript controllata |
Il file dei risultati pubblicato registra velocità di output di 48-52 token al secondo per la prima attività, 40-43 per la seconda e 37-44 per la terza. «Fino a 52» è un picco osservato, non una velocità sostenuta per ogni attività.
Le prime tre attività estendono una sola applicazione. I conteggi 5/5, 6/6 e 7/7 descrivono suite di test successive. Sommarli non dimostra 18 capacità indipendenti. Anche i test scritti dallo stesso agente richiedono una revisione della copertura e delle asserzioni.
Il recupero dell’ambiente faceva parte del lavoro. L’agente ha recuperato da un comando shell inadatto e ha identificato un server applicativo obsoleto durante i test. Sono comportamenti utili, anche se terminare un processo esistente richiede permessi deliberati in un ambiente di sviluppo condiviso.
Docker resta non verificato. L’agente ha scritto un Dockerfile, ma non disponeva di un motore Docker attivo per la build. I test applicativi superati fuori dal container non dimostrano il funzionamento dell’immagine. Il nuovo tentativo del gioco ha controllato la sintassi e aperto un browser, ma l’agente non ha avuto conferma visiva diretta del gameplay.
Riserva spazio per l’output
{
  "reasoning_budget_tokens": 8000
}
Unisci questa impostazione alla configurazione esistente strata-iq3_s.json, conservando gli altri campi, poi riavvia il modello Strata scelto. È un’impostazione Strata, non un file di configurazione OpenCode sostitutivo. Verifica il budget attivo nell’output di avvio.
Strata documenta un budget di ragionamento rigido che termina la fase di pensiero e passa alla risposta. Un valore a livello di richiesta sostituisce il valore predefinito configurato. L’impostazione differisce da un’istruzione generica sul livello di ragionamento come low o high.
Il primo tentativo del gioco ha esaurito la sua allowance di 16.384 token durante la pianificazione. Il nuovo tentativo ha usato un budget di pensiero di 8.000 token e ha prodotto codice. Questo sostiene l’uso di una fase di ragionamento limitata per questo carico. Non dimostra che 8.000 sia l’impostazione migliore per ogni attività.
L’output rimanente è un massimo, non una garanzia di prenotazione. Se un limite di 8.000 token fosse consumato interamente sotto un limite totale di 16.384, resterebbero circa 8.384 token prima dell’overhead. Il registro dei risultati riporta 11.054 token scritti nel nuovo tentativo, senza una ripartizione completa tra ragionamento e codice. Non interpretarlo come 8.000 token di ragionamento più 11.054 token di codice sotto lo stesso limite.
Usa un budget più piccolo per modifiche strette, poi prova budget più grandi per attività che richiedono più analisi. Controlla l’output completo del file, lo stato di completamento e i risultati dei test. Più tempo di pianificazione è utile solo se migliora la modifica consegnata.
Collegare Strata e OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Questo è il punto di ingresso per l’installazione Linux. Controlla le istruzioni correnti e usa START-HERE.bat per il percorso Windows documentato. Seleziona la variante originale Qwen3.8-Flash-Next IQ3_S e un contesto di 65.536 token per avvicinarti alla configurazione riportata. Salva versione del motore e file del modello nelle note del benchmark.
npm install -g opencode-ai
Installa OpenCode seguendo le sue
istruzioni ufficiali
. In un terminale separato, definisci STRATA_BASE_URL come la base API locale stampata da Strata, incluso il suffisso /v1. Mantieni l’inferenza legata alla macchina locale per questa configurazione.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Unisci il blocco provider in ~/.config/opencode/opencode.json, conservando le impostazioni esistenti. Questo adatta l’
esempio di configurazione pubblicato
caricando l’endpoint locale da una variabile d’ambiente. OpenCode documenta i
provider personalizzati
e la
sostituzione delle variabili d’ambiente
.
local è una credenziale segnaposto, coerente con l’esempio locale senza autenticazione. Non protegge un server. Se l’istanza Strata abilita l’autenticazione, fornisci la credenziale configurata tramite il meccanismo locale appropriato.
Avvia opencode in una copia usa e getta del progetto e seleziona il modello configurato. Verifica il provider selezionato prima di inviare codice. La dichiarazione del contesto lato client non aumenta il contesto configurato dal server, e una finestra da 65.536 token non lascia 65.536 token per l’input quando serve spazio anche per l’output.
Inferenza locale e permessi
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Unisci questi permessi iniziali alla configurazione OpenCode durante la valutazione dell’agente. La documentazione dei permessi spiega i controlli disponibili. Le modifiche ai file e l’esecuzione shell influenzano la macchina indipendentemente da dove gira l’inferenza.
L’inferenza locale non rende locali tutti gli strumenti. Download dei pacchetti, strumenti web, integrazioni esterne e condivisione opzionale coinvolgono ancora servizi di rete. Esamina gli strumenti attivi prima di trattare repository privati. «Il modello gira localmente» è un’affermazione più limitata di «nulla lascia il computer».
Risoluzione dei problemi al primo avvio
| Sintomo | Primo controllo |
|---|---|
| Provider non disponibile | Strata è in esecuzione e la variabile d’ambiente raggiunge il processo OpenCode |
| Modello assente dalla selezione | ID del provider e ID del modello corrispondono alla configurazione salvata |
| Errore limite di contesto | Lunghezza del prompt più output richiesto rientrano nella finestra attiva del server |
| Pianificazione senza codice | Budget di ragionamento, limite totale di output e stato di completamento |
| Continuazione lenta | Riuso del prefisso, pressione sulla memoria, comportamento della cache degli esperti e processi concorrenti |
| Comando Docker fallisce | È disponibile un motore funzionante, non solo il client da riga di comando |
Cambia una sola impostazione alla volta e ripeti la stessa attività da uno stato iniziale salvato. Questo separa un miglioramento della configurazione da un prompt diverso o da un test più facile.
Sostituisce un abbonamento?
| Vale la pena testare la configurazione locale | Mantieni disponibile un’altra opzione |
|---|---|
| Hardware compatibile già disponibile | Acquistare hardware solo per un carico non testato |
| Modifiche applicative delimitate | Repository grandi e sconosciuti e migrazioni difficili |
| Test di accettazione ripetibili | Attività senza metodi affidabili per controllare la correttezza |
| Tempo per la manutenzione del runtime | Lavoro che richiede poca preparazione e supporto |
La spesa API pari a zero è significativa, soprattutto quando l’hardware è già disponibile. Esclude elettricità, deprezzamento dell’hardware, archiviazione e tempo di manutenzione dell’ambiente. Anche il campo di costo zero visualizzato non misura queste spese.
Confrontare un abbonamento richiede attività equivalenti. Usa lo stesso repository iniziale, le stesse istruzioni e gli stessi controlli di accettazione in entrambi i sistemi. Registra nuovi tentativi e correzioni umane insieme al tempo trascorso. Includi il primo tentativo fallito del gioco nella valutazione del flusso completo, invece di riportare solo il nuovo tentativo riuscito.
Un agente locale utile non deve essere superiore in assoluto. Se gestisce in modo affidabile le modifiche di routine e lascia un piccolo gruppo di attività difficili a un altro strumento, cambia già quali servizi a pagamento ti servono. Decidi in base al lavoro accettato nei tuoi progetti.
Dimostrazione e prossimi passi
Per approfondire: La dimostrazione dell’agente di programmazione locale 125B . Le misure riportate appartengono al test pubblicato, non a un benchmark indipendente eseguito per questo articolo.
- Riproduci una piccola attività con criteri di accettazione fissi e una revisione iniziale salvata.
- Misura turni freddi e caldi invece di trattare il riuso del prefisso come velocità di prefill a freddo.
- Verifica il packaging separatamente con una build dell’immagine riuscita, avvio e controlli a livello container.
- Esamina i test generati e aggiungi i casi non previsti dall’implementazione.
- Confronta il lavoro completato con lo strumento di programmazione attuale prima di modificare gli abbonamenti.
Per pianificare l’hardware, leggi la guida al contesto dei modelli IA locali e delle GPU . Per il comportamento dei modelli ospitati, consulta routing dei provider e costi di OpenRouter .
Related Posts