Routing dei provider OpenRouter: qualità del modello, limiti dei token e costi reali
Table of Contents
Il routing dei provider OpenRouter determina quale servizio di inferenza risponde alla richiesta. Due chiamate con lo stesso nome del modello dipendono comunque dai limiti dell’endpoint, dai parametri supportati, dal software di servizio e dalle preferenze di routing. Se le risposte diventano più brevi o le chiamate agli strumenti falliscono, controlla queste differenze prima di attribuire il problema alla quantizzazione.
Punti chiave
- Le etichette di precisione descrivono un formato numerico, non un punteggio di accuratezza.
- I limiti dell’endpoint determinano contesto disponibile, lunghezza dell’output e supporto delle funzioni.
- Il routing esplicito richiede una policy di fallback oltre a una preferenza per il provider.
- Auto Exacto migliora la selezione dei provider usando segnali di qualità e offre una route opt-in per le richieste senza strumenti.
- Il costo effettivo include output, comportamento della cache, nuovi tentativi e completamento riuscito della task.
Prerequisiti: familiarità con le richieste JSON e accesso alla configurazione OpenRouter dell’applicazione. L’ispezione degli endpoint usa un’API pubblica. L’invio di richieste al modello richiede una chiave API e comporta costi di utilizzo. Ricontrolla i metadati dell’endpoint prima di ripetere un esempio datato.
Tempo e difficoltà: circa 20 minuti per una prima revisione della configurazione. Livello intermedio. Un confronto utile tra provider richiede test aggiuntivi con prompt rappresentativi.
Cosa omette il nome del modello
Un identificatore del modello seleziona il modello richiesto. Il provider esegue il servizio di inferenza, inclusi implementazione del modello, limiti dei token e parser delle chiamate agli strumenti. Un benchmark a livello di modello non valida ogni servizio che ospita quei pesi.
| Proprietà dell’endpoint | Cosa controllare |
|---|---|
| Lunghezza del contesto | Spazio per prompt, cronologia, risultati degli strumenti e generazione |
| Lunghezza massima della completion | Budget di output per la task richiesta |
| Parametri supportati | Uso degli strumenti, output strutturato, sampling e controlli di ragionamento |
| Quantizzazione | Formato dichiarato confrontato con la release originale |
| Prezzi | Input, output, letture dalla cache e costi aggiuntivi applicabili |
| Comportamento del servizio | Qualità della completion, errori di parsing, latenza e nuovi tentativi |
Il routing di base favorisce prezzi inferiori tra i candidati disponibili. OpenRouter documenta una ponderazione inversa al quadrato del prezzo. Nel suo esempio semplificato, un candidato da 1 $ riceve un peso di selezione nove volte maggiore rispetto a un candidato da 3 $. Sono pesi relativi, non una garanzia per la prossima richiesta. Anche ordine esplicito, ordinamento, caching e routing per qualità influenzano la selezione. Consulta la documentazione sul routing dei provider .
La ponderazione del prezzo non dimostra quale sarà la fattura più bassa per il tuo carico. L’esempio documentato non specifica una combinazione universale di input e output per lo scalare del prezzo. Non dedurre la probabilità di selezione di un provider dal solo prezzo di input.
Leggere la precisione nel contesto
La quantizzazione memorizza i valori numerici con una rappresentazione ridotta. Il suo effetto dipende da modello, metodo e implementazione dell’inferenza. Una precisione inferiore richiede test, ma l’etichetta da sola non dimostra che il provider abbia modificato i pesi originali.
GPT-OSS offre un esempio concreto. La documentazione della release gpt-oss-120b di OpenAI dichiara che i pesi mixture-of-experts usano MXFP4 e che le valutazioni hanno usato la stessa quantizzazione. Un’etichetta a quattro bit per questi pesi è coerente con la release pubblicata. Non dimostra un ulteriore peggioramento da parte del provider.
L’upcasting converte i valori memorizzati in una rappresentazione più ampia. Convertire in BF16 un checkpoint già quantizzato non recupera le informazioni scartate durante la quantizzazione. Al contrario, convertire in quattro bit un checkpoint nato con precisione maggiore introduce un cambiamento distinto da valutare.
| Osservazione | Conclusione supportata |
|---|---|
| Checkpoint MXFP4 nativo | I pesi esperti a quattro bit appartengono alla release |
| Etichetta BF16 dell’endpoint | Formato dichiarato più ampio, senza prova di risposte migliori |
| Precisione sconosciuta | Metadati assenti, senza prova di degrado nascosto |
| Etichette di precisione uguali | Prova insufficiente di comportamento equivalente del servizio |
Etichette uguali non escludono differenze di quantizzazione. Non indicano quali tensori siano stati quantizzati, quale calibrazione sia stata usata o quali kernel vengano eseguiti. Testa l’endpoint completo invece di trattare la profondità in bit come una classifica di qualità.
Controllare il budget dei token
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
L’API degli endpoint espone i metadati del provider per un modello. Il comando richiede curl e jq. Controlla la
risposta live dell’endpoint gpt-oss-120b
prima di scegliere un servizio. Tratta i campi mancanti o null come sconosciuti, non come illimitati. Salva uno snapshot locale datato quando confronti i risultati.
Un controllo del 5 ottobre 2026 ha restituito questi limiti dichiarati per gpt-oss-120b. Sono valori dei metadati, non lunghezze misurate delle completion, e i provider li cambiano nel tempo.
| Provider | Token di contesto | Token massimi di completion |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
La lunghezza del contesto e quella dell’output sono limiti separati. Un modello con contesto lungo richiede comunque spazio sufficiente per la risposta. Cronologia, istruzioni di sistema e definizioni degli strumenti consumano spazio insieme al documento dell’utente.
I token di ragionamento consumano anche il budget di generazione nei modelli che li supportano. Un limite ridotto rischia ragionamento incompleto, poco output visibile o terminazione prima della risposta finale. Controlla l’utilizzo e il motivo di fine invece di presumere che ogni risposta breve rifletta pesi più deboli. OpenRouter spiega questo budget nella documentazione sui token di ragionamento .
Un max_tokens esplicito fornisce al router una lunghezza di output richiesta da confrontare con il supporto del provider. Sceglila in base alle necessità misurate della task e al contesto disponibile. Un valore eccessivo riduce l’idoneità e non garantisce una risposta più lunga o migliore.
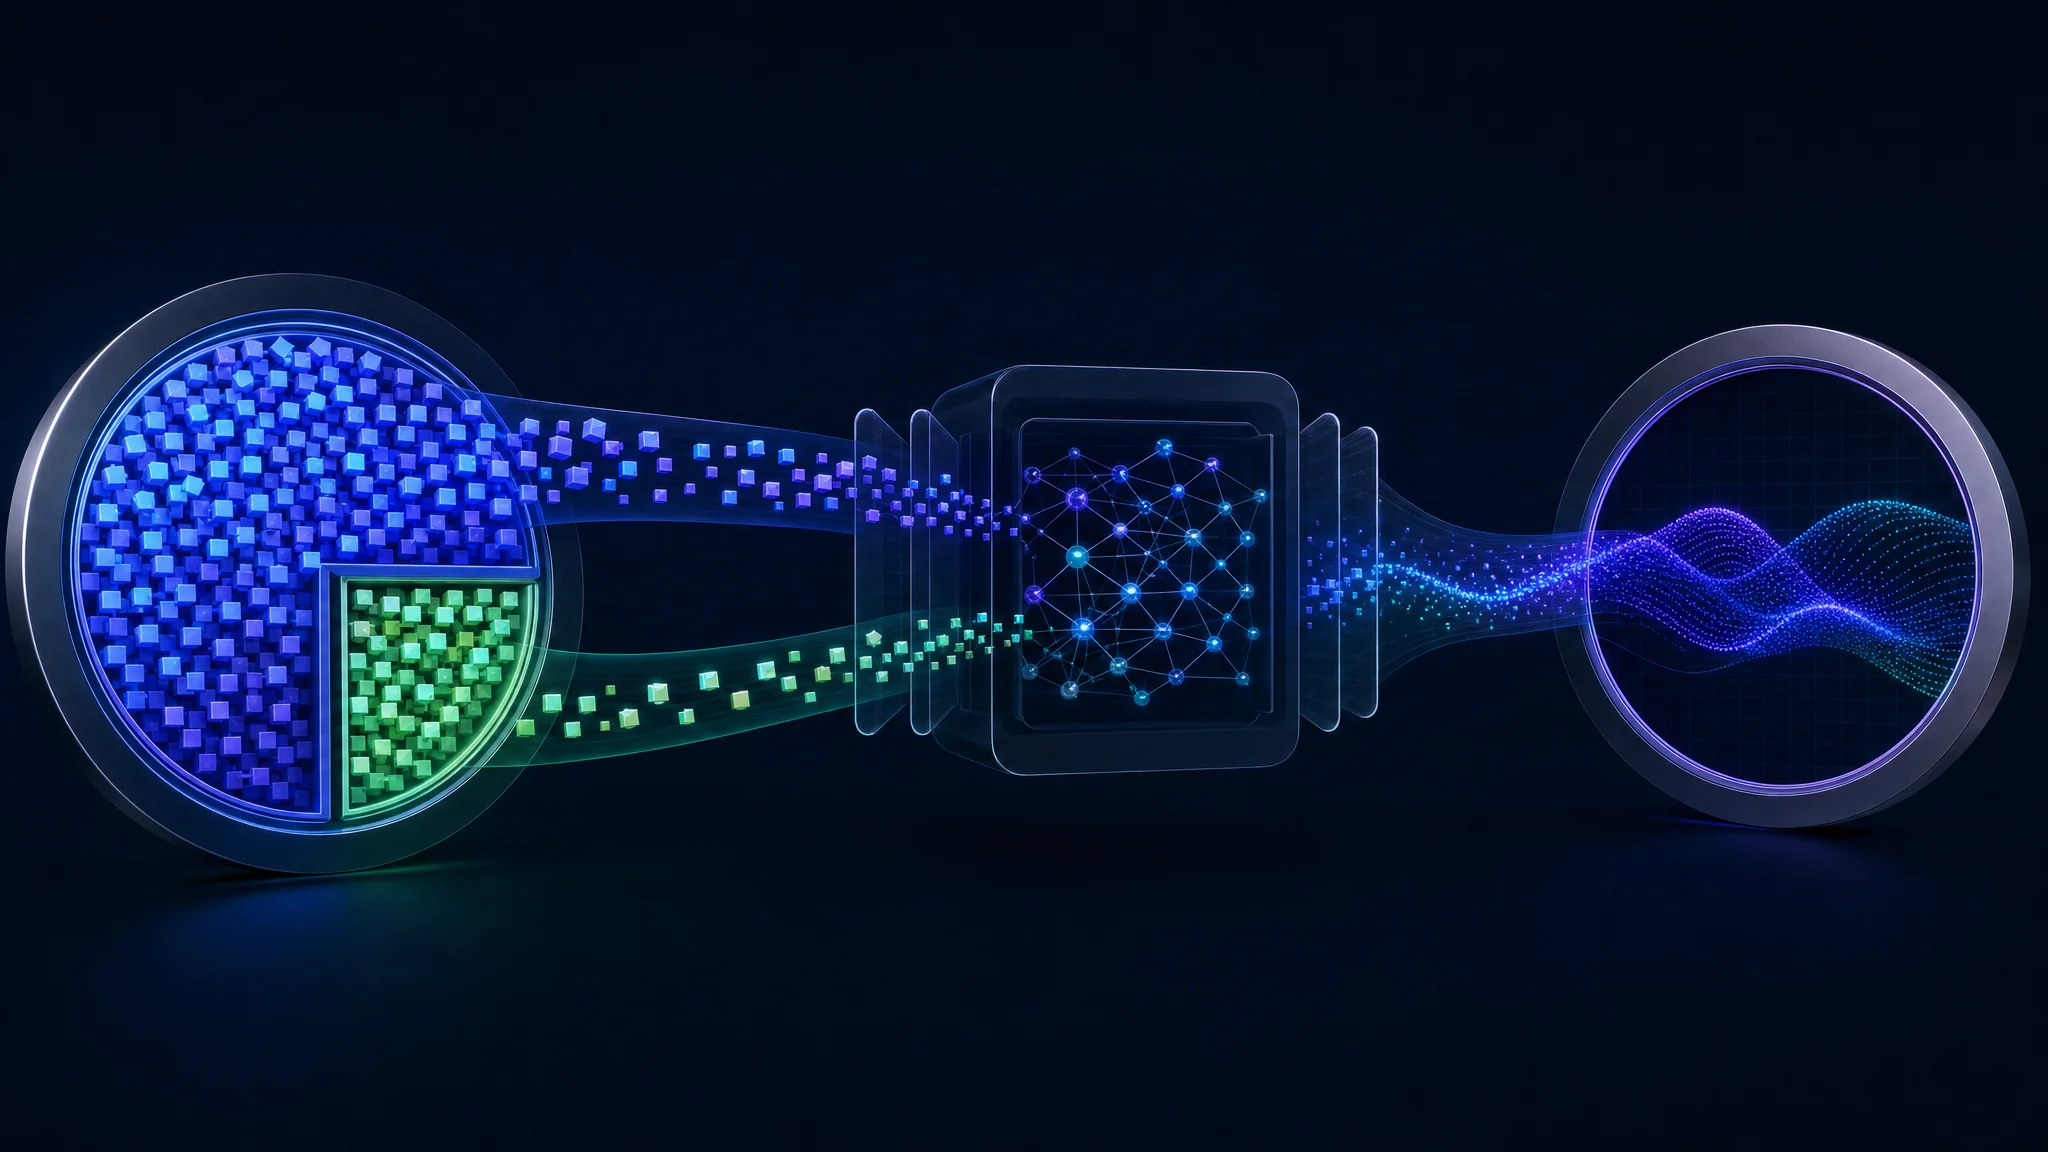
Allocazione concettuale dei token, con ragionamento e output visibile che condividono il budget della completion nei provider supportati
Richiedere i parametri
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters vale false per impostazione predefinita. Con il routing predefinito, i parametri non supportati non escludono necessariamente un endpoint. OpenRouter documenta che i provider ignorano i parametri sconosciuti. Impostando questo campo a true filtri il routing in base al supporto dichiarato.
I metadati di supporto non garantiscono il comportamento. Un endpoint che dichiara il supporto per seed richiede comunque test di riproducibilità. Un endpoint compatibile con gli strumenti richiede validazione dello schema e test a livello applicativo. Il filtro impedisce alle incompatibilità note di entrare nel gruppo dei candidati.
Fissare i provider in modo intenzionale
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Sostituisci il placeholder con uno slug del provider copiato dall’elenco dei provider del modello. Invia il report nella richiesta reale. Questo modello serve alla revisione della configurazione. Diventa eseguibile solo dopo aver sostituito il placeholder.
order stabilisce una preferenza. Da solo lascia attivi i fallback verso altri provider. Abbinarlo a allow_fallbacks: false limita il routing ai provider elencati. La richiesta fallirà se nessuno soddisfa la richiesta o resta disponibile.
Le varianti degli endpoint richiedono attenzione. Uno slug di base del provider corrisponde a più varianti secondo le regole di corrispondenza documentate. Usa lo slug della variante specifica per testare una particolare configurazione del servizio. Ricontrolla il provider indicato per ogni risposta.
quantizations è una allowlist di formati nominati, non un minimo numerico. Un array contenente "fp8" seleziona gli endpoint FP8 corrispondenti. Non include automaticamente BF16 o tutti i formati con più bit. Confronta prima il checkpoint originale, poi applica il filtro solo quando la tua valutazione sostiene la restrizione.
Mantenere attivo il routing qualità
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto usa throughput, telemetria delle chiamate agli strumenti e benchmark per de-prioritizzare i provider meno performanti. L’ annuncio di OpenRouter del marzo 2026 riporta una riduzione dell'88% negli errori delle chiamate agli strumenti di GLM-5, con il tasso passato da circa l'8% a circa l'1%. Riporta anche il passaggio di gpt-oss-120b dal 5,6% al 3,5%.
Sono risultati dichiarati dal provider, non una promessa per la tua applicazione. La validità di una chiamata agli strumenti misura JSON, nomi e schemi. Una chiamata sintatticamente valida richiede comunque gli argomenti corretti e l’azione corretta per la task dell’utente.
Le richieste che contengono strumenti ricevono Auto Exacto per impostazione predefinita quando il modello dispone di copertura sufficiente dei provider. Per le altre richieste, :exacto attiva il routing qualità. La documentazione attuale supporta quindi il routing qualità per riassunti e chat oltre che per l’uso degli strumenti.
sort: "price", il suffisso :floor e un ordinamento per prezzo predefinito a livello account disattivano Auto Exacto. Controlla insieme le impostazioni dell’applicazione e le preferenze dell’account. Consulta la
documentazione Auto Exacto
prima di combinare i controlli di routing.
Calcolare il costo del carico
Il prezzo di input da solo offre un confronto incompleto. Considera queste tariffe illustrative, espresse in dollari per milione di token. Mostrano l’aritmetica e non sono quotazioni correnti dei provider.
| Endpoint illustrativo | Prezzo input | Prezzo output |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
L’endpoint A costa circa 4,2 volte di più per questa combinazione nonostante il prezzo input più basso. Il rapporto 533 a 1 tra i prezzi output e input di A confronta due tariffe. Non moltiplica il costo totale dell’utente. Proporzioni diverse tra input e output cambiano il confronto.
Le unità di prezzo dell’API differiscono dalle tabelle di confronto. L’API degli endpoint esprime i prezzi dei token per token. Moltiplicali per un milione prima di confrontarli con le tariffe sopra.
Il caching dei prompt introduce un’altra variabile. Letture della cache, scritture della cache e input non memorizzati richiedono contabilità separata secondo le regole di fatturazione del provider. Il testo ripetuto non garantisce un cache hit. Controlla quantità e costi dei token memorizzati usando la documentazione sul caching dei prompt .
Il routing influisce sulla continuità della cache. OpenRouter documenta un routing sticky per il caching, mentre l’ordine manuale dei provider ha precedenza. Auto Exacto riordina anche i provider e a volte interrompe una cache calda. Confronta il risparmio osservato della cache con i costi di qualità e nuovi tentativi prima di cambiare una delle due policy.
Il costo per risultato accettato è la metrica utile dell’applicazione. Dividi la spesa totale, inclusi nuovi tentativi e richieste fallite, per i risultati che rispettano i criteri di accettazione. Includi separatamente eventuali costi non legati ai token. Un prezzo basso dei token non compensa task ripetutamente fallite.
Diagnosticare una risposta incoerente
| Sintomo | Primo controllo |
|---|---|
| Risposta breve o incompleta | Motivo di fine, budget di output, uso del ragionamento |
| Dettagli del documento mancanti | Contenuto inviato, limite di contesto dell’endpoint, troncamento del client |
| Chiamata allo strumento malformata | Supporto dichiarato, schema dello strumento, comportamento del parser |
| Comportamento di sampling diverso | Parametri richiesti e supporto dichiarato |
| Spesa inattesa | Volume output, letture cache, nuovi tentativi, cambiamenti del provider |
| Nessun provider idoneo | Limiti in conflitto, allowlist e restrizioni di fallback |
Conserva il generation ID restituito con la risposta. L’ API dei metadati di generazione di OpenRouter espone identità del provider, utilizzo, costo e informazioni sulla fine. Un session ID raggruppa il lavoro collegato, ma non sostituisce il generation ID per una singola richiesta.
Salva la richiesta insieme al generation ID. Conserva insieme modello, preferenze del provider, parametri richiesti, timestamp e utilizzo della risposta. Questo rende riproducibile un confronto futuro di qualità o costo quando cambiano routing, prezzi o metadati degli endpoint.
Confronta gli endpoint in condizioni uguali. Usa lo stesso prompt, gli stessi strumenti, le stesse impostazioni di ragionamento e lo stesso budget di token. Ripeti su diverse task rappresentative. Separa risposte incomplete, chiamate agli strumenti non valide e risposte errate invece di unirle in un punteggio di qualità senza spiegazione.
L’incertezza dei benchmark conta. L’ analisi di Epoch AI sul benchmarking descrive variazioni dovute a implementazioni, sampling e scaffold degli agenti. Una risposta deludente non dimostra un difetto persistente del provider né ne identifica la causa.
Procedura guidata per il routing degli endpoint
Per approfondire: Discussione sulla qualità e sul routing degli endpoint OpenRouter . Ricontrolla gli elenchi degli endpoint prima di applicare prezzi, limiti o confronti specifici tra provider.
Prossimi passi
- Ispeziona gli endpoint di un modello e registra i limiti utili per il tuo carico.
- Seleziona una policy di routing con requisiti espliciti sui parametri e comportamento del fallback.
- Testa task rappresentative sugli endpoint candidati e sul routing qualità.
- Registra il costo per risultato accettato insieme a latenza, uso della cache e categorie di errore.
- Ricontrolla dopo i cambiamenti a versioni del modello, comportamento del servizio o prezzi dei provider.
Per le basi più ampie dell’IA, continua con Concetti fondamentali dell’IA . Per i permessi degli agenti e i controlli di validazione, leggi Proteggere i sistemi IA .
Related Posts