16 GB di VRAM sono sufficienti per un lavoro serio con LLM locali?
Table of Contents
16 GB di memoria GPU dedicata supportano un lavoro serio con LLM locali quando modello, contesto e runtime entrano insieme. Caricare i pesi dimostra solo il primo requisito. Una configurazione utile richiede anche memoria sufficiente per la conversazione in corso e velocità sufficiente per completare il compito.
Usa Qwen3.8 27B come esempio per definire il budget di un flusso di coding o documenti per un singolo utente. Parti dal contesto richiesto dal compito, poi scegli pesi e impostazioni del runtime compatibili con la memoria restante. Le specifiche hardware e le fonti del modello sono state controllate il 7 ottobre 2026.
Punti chiave
- Riserva memoria per il contesto prima di scegliere una quantizzazione.
- Misura l’elaborazione del prompt separatamente dalla velocità di output.
- Disattiva il supporto vision inutilizzato e prova una cache KV a 8 bit.
- Confronta GPU esatta, backend, file del modello e lunghezza del prompt.
- Calcola il risparmio di possesso in base al carico di lavoro e alla fattura del provider.
Per l’esercizio di budget servono il log della memoria del runtime, il nome esatto del file del modello e un compito rappresentativo. Dedica circa 20 minuti alla configurazione e alla registrazione dei risultati, oltre al tempo di inferenza. La difficoltà è intermedia.
Abbina la memoria al lavoro
16 GB sono adatti a un carico i cui pesi, contesto attivo e allocazioni temporanee restano nella memoria GPU disponibile. Il contesto richiesto dipende dal compito. Un breve riepilogo di un documento e un agente di coding che legge decine di file richiedono budget diversi.
| Carico di lavoro | Prima domanda di dimensionamento |
|---|---|
| Chat breve o stesura | Il modello raggiunge l’obiettivo di qualità? |
| Analisi documenti | Testo sorgente e risposta entrano insieme? |
| Agente di coding | Quanto contesto consumano file e risultati degli strumenti? |
| Richieste simultanee | Quanta cache serve a ogni sessione attiva? |
Una finestra configurata differisce da una finestra occupata. Un benchmark con limite 64K e prompt breve non misura la generazione dopo 55K token di conversazione. Prova vicino alla lunghezza prevista della sessione prima di scegliere l’hardware.
Perché il modello entra
La quantizzazione memorizza i pesi con meno bit. La tabella dei file Qwen3.8 27B di Bartowski indica Q4_K_M a 17.44 GB, già oltre i circa 17.18 miliardi di byte di un dispositivo da 16 GiB prima della memoria del runtime.
La model card GSQ-RCO di ISTA-DASLab indica IQ3_S a 11.8 GB. Il metodo assegna precisioni diverse ai tensori entro un budget di dimensione. La versione MTP opzionale aggiunge circa 0.35 GB, mentre il proiettore vision aggiunge circa 0.9 GB.
| Benchmark pubblicato | Punteggio BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
Il laboratorio definisce questo punto operativo “task-lossless”. Questi risultati selezionati sostengono un confronto circoscritto. Non dimostrano risposte identiche, recupero uguale su contesti lunghi o affidabilità uguale nelle attività di coding. Prova il modello compresso con i tuoi criteri di accettazione.
Conta la cache
La cache KV conserva chiavi e valori di attenzione dei token già elaborati. Prompt, output degli strumenti e risposte generate consumano contesto. Alcuni runtime allocano la capacità della cache all’avvio, quindi la memoria mostrata non deve crescere a ogni messaggio.
La configurazione di Qwen specifica 64 layer, attenzione completa ogni quarto layer, quattro teste KV e dimensione della testa 256. Per i 16 layer con attenzione completa, il costo calcolato della cache FP16 è:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Il calcolo esclude stato ricorrente, allineamento, buffer temporanei e allocazioni del decoding speculativo. Le altre architetture richiedono calcoli diversi.
| Token occupati | Cache di attenzione completa FP16 |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
Qui KiB e GiB usano potenze di 1024. Le dimensioni dei download dei modelli usano GB decimali. Mescolare le unità altera il budget residuo.
Definisci il budget del contesto disponibile
Due impostazioni liberano memoria per sessioni di testo più lunghe: rimuovere un proiettore vision inutilizzato e ridurre la precisione della cache. Calcola il loro effetto rispetto al modello caricato e alle allocazioni del runtime.
Usa questo esempio, con ogni allocazione espressa in GB decimali. La riserva di 1.0 GB sotto è un’ipotesi di pianificazione, non un valore predefinito universale del runtime.
| Allocazione | Vision attiva / vision disattivata |
|---|---|
| Capacità fisica 16 GiB | 17.180 / 17.180 GB |
| Pesi del modello | 11.800 / 11.800 GB |
| Testa MTP opzionale | 0.350 / 0.350 GB |
| Stima del proiettore vision | 0.930 / 0 GB |
| Altre allocazioni assunte | 1.000 / 1.000 GB |
| Spazio per cache crescente | 3.100 / 4.030 GB |
A 65,536 byte per token, 3.100 GB contengono circa 47,300 token. Con archiviazione ideale a 8 bit, 32,768 byte per token contengono circa 123,000 token con vision disattivata.
L’archiviazione q8_0 reale include scale dei blocchi. Con 34 byte per 32 valori, questo esempio richiede circa 34,816 byte per token, riducendo la stima a circa 115,700. Le allocazioni aggiuntive riducono ancora il risultato. Circa 110K è quindi un risultato plausibile di pianificazione in queste ipotesi, non un’impostazione garantita.
Il contesto restante deve coprire input e output. Con una finestra da 65,536 token, un prompt iniziale illustrativo da 30,000 token e un’uscita consentita da 8,192 token restano 27,344 token per file, risultati degli strumenti e conversazione. Il budget del prompt iniziale è un esempio. Misura strumenti e istruzioni reali.
Impostazioni da provare
La documentazione del server llama.cpp documenta tipi separati per cache delle chiavi e dei valori, caricamento automatico del proiettore e slot paralleli. Per un carico solo testo, prova vision disattivata, q8_0 per entrambi i tipi di cache e uno slot. Parti da un contesto moderato.
Registra le allocazioni risultanti prima di aumentare il contesto. La quantizzazione della cache richiede supporto dall’architettura e dal backend scelti. Prova la qualità delle risposte dopo aver cambiato precisione. Conserva una configurazione funzionante per il confronto.
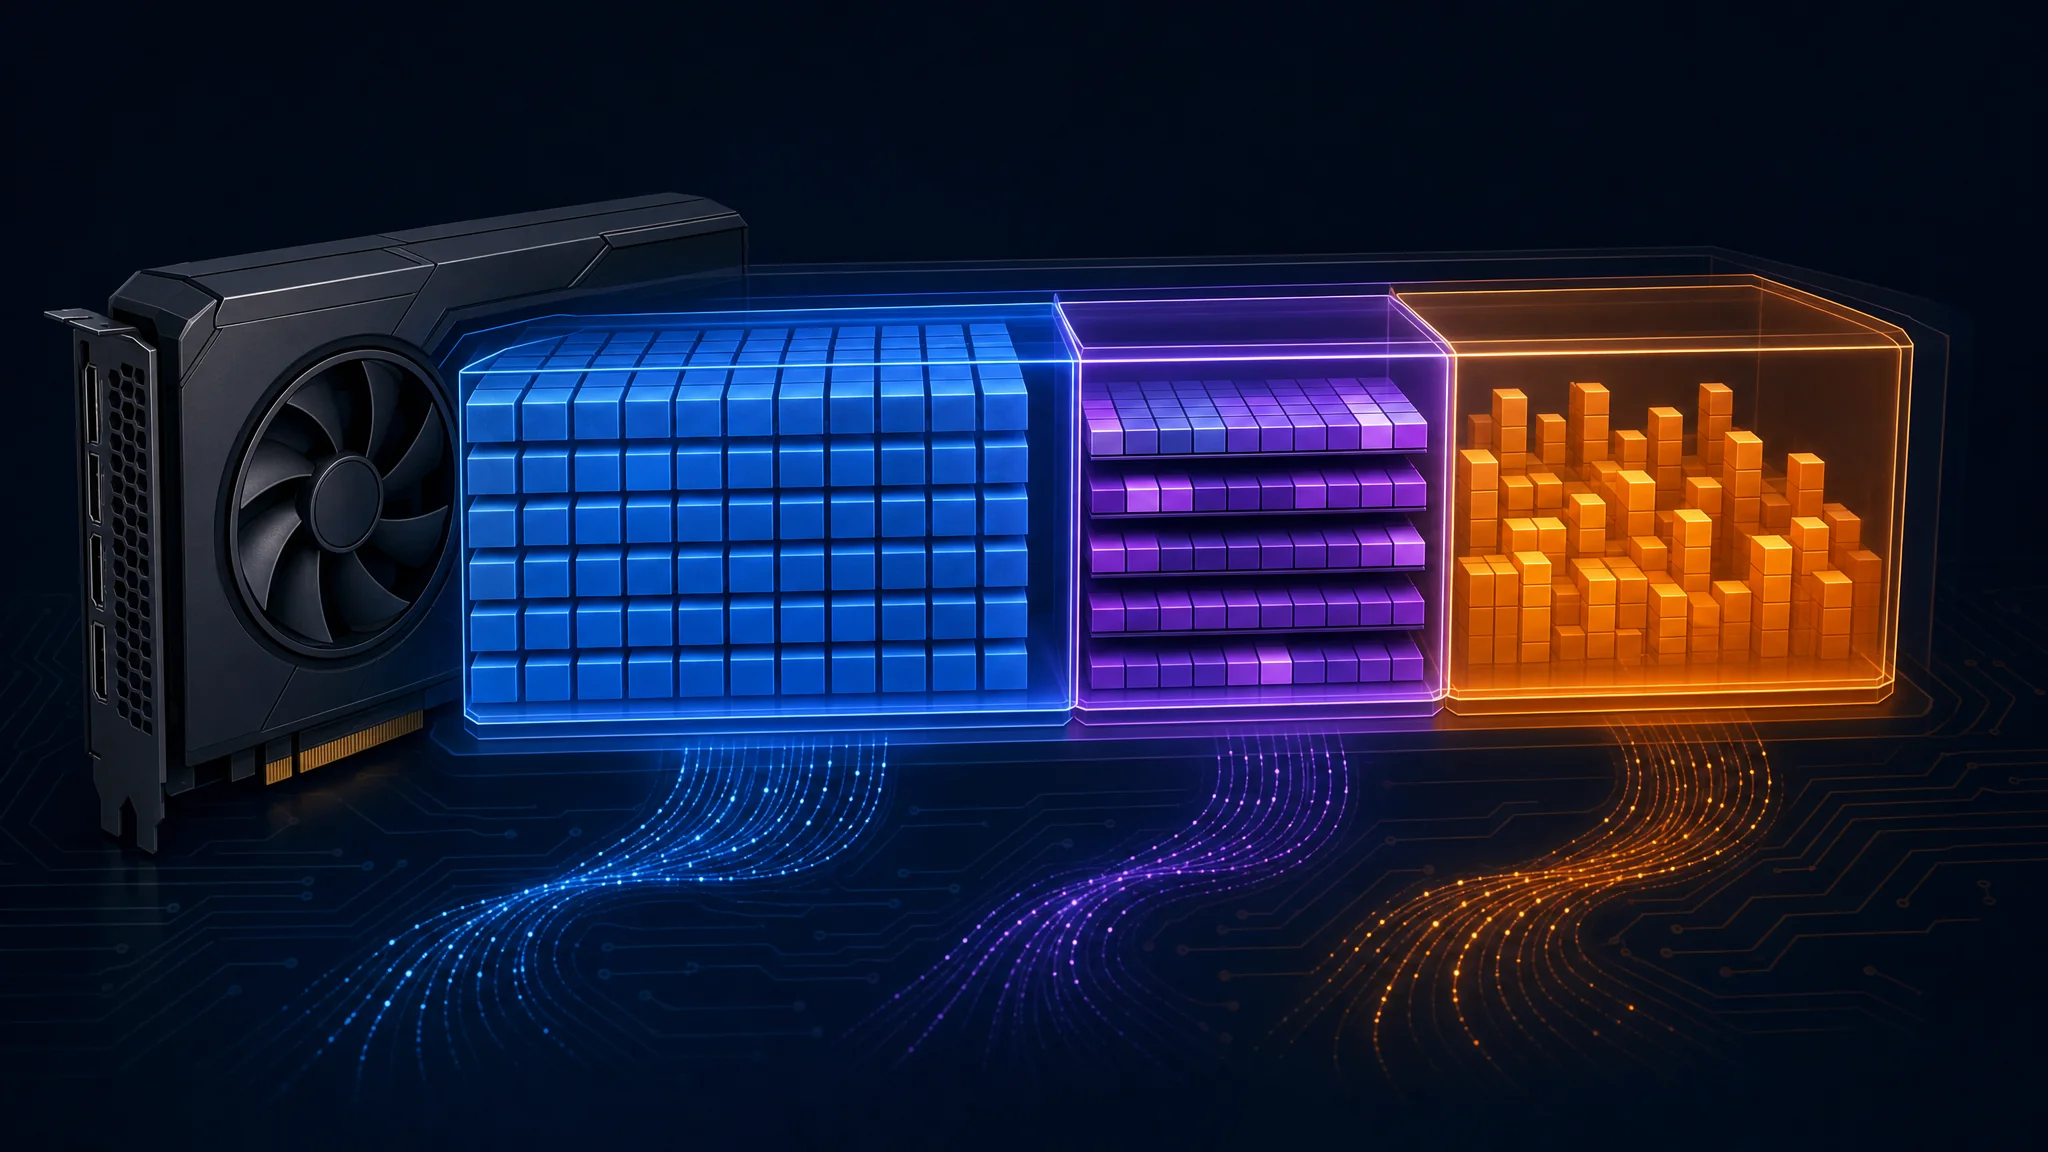
Il blu rappresenta i pesi, il viola la cache del contesto e l’arancione le allocazioni del runtime. Le dimensioni sono illustrative
Perché le velocità differiscono
Un’etichetta 16GB descrive la capacità. Il throughput dipende anche da larghezza di banda della memoria, kernel di calcolo, contesto attivo, offload, batching e decoding speculativo.
| Causa | Cosa controllare |
|---|---|
| Offload su CPU o RAM | Posizione dei layer caricati e della cache |
| Contesto lungo | Token occupati durante la misura |
| Differenze di backend | Commit del runtime, driver e percorso del kernel |
| Decoding speculativo | Draft accettati e allocazioni aggiuntive |
Per un modello denso che genera un token alla volta, la larghezza di banda della memoria divisa per i byte dei pesi residenti offre una stima approssimativa basata solo sulla banda. A 448 GB/s e 11.8 GB di pesi, il quoziente è circa 38 token al secondo. Letture della cache e calcolo aggiungono lavoro, mentre decoding speculativo e batching cambiano le ipotesi.
Non trattare questo quoziente come un limite superiore universale. Un output rate riportato più alto non invalida automaticamente un benchmark. Controlla se un passaggio del modello obiettivo ha accettato più token draft.
La predizione multi-token, o MTP, richiede modello e runtime compatibili. Confronta esecuzioni attive e disattive con contesto occupato breve e lungo. Pesi aggiuntivi e stato draft consumano memoria, ma nessuna regola universale impone di disattivare MTP dopo 32K token.
Misura la prima risposta
Il prefill elabora il prompt prima della generazione. Il decode produce la risposta. Un decode rapido nasconde una prima risposta lenta quando un compito inizia con un prompt ampio non memorizzato in cache.
Dividi i token del prompt non in cache per il throughput di prefill misurato per stimare il tempo di elaborazione. Per un prompt nuovo da 30,000 token, due velocità illustrative producono questi tempi:
| Velocità prompt di esempio | Tempo di elaborazione calcolato |
|---|---|
| 750 token/s | 40 secondi |
| 150 token/s | 200 secondi |
Gli esempi descrivono il tempo di elaborazione, esclusi caricamento del modello e overhead della richiesta. Lunghezza del prompt, dimensione del batch, formato del modello e backend influenzano la velocità misurata.
Misura separatamente una richiesta fredda e una continuazione con prefisso riutilizzabile. Riutilizzare il prefisso evita di elaborare parte dell’input ripetuto. Registra il tempo al primo token insieme al decode rate e alla durata totale del compito.
Confronta configurazioni GPU complete
Confronta insieme prezzo d’acquisto, memoria utilizzabile, banda e percorso software. Una scheda meno costosa perde il vantaggio se il carico richiede funzioni non supportate o supera l’obiettivo di latenza.
| Scheda desktop 16GB | Larghezza di banda memoria |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Le specifiche AMD della RX 9070 e le specifiche della RX 9070 XT confermano capacità 16GB e banda fino a 640 GB/s. Il confronto 640 contro 448 produce circa il 43% di banda teorica in più. Da queste specifiche non segue un miglioramento dell’inferenza del 43%.
Scegli benchmark con il modello e il backend previsti. Per prompt brevi e generazione sostenuta, dai più peso alle prestazioni di decode. Per analisi di repository, privilegia prefill freddo, velocità su contesto lungo e completamento riuscito del compito. Controlla il software disponibile prima di acquistare uno dei due marchi.
Mac e diciture dei portatili
Un Mac Apple silicon da 16GB condivide la memoria tra CPU, GPU, sistema operativo e applicazioni. Una GPU discreta da 16GB ha memoria video dedicata oltre alla RAM di sistema. Queste capacità non descrivono budget equivalenti per il modello.
Apple espone una dimensione consigliata del working set GPU . Controlla il limite indicato dal runtime e la pressione della memoria di sistema. Lascia spazio per macOS e altre applicazioni invece di assegnare tutto il pool condiviso all’inferenza.
Per i portatili, controlla SKU esatto, memoria dedicata, limite di potenza della GPU e raffreddamento del produttore. La pagina della famiglia RTX 5060 di NVIDIA elenca le varianti di memoria della RTX 5060 Ti desktop. Il nome della famiglia non dimostra 16GB, e i risultati desktop non dimostrano il throughput del portatile.
Conviene possedere l’hardware?
Possedere l’hardware conviene finanziariamente quando gli addebiti di hosting evitati superano i costi operativi e recuperano il prezzo d’acquisto. Parti da un esempio con solo output: scheda da 789 $, 35 token di output/s, 180 W durante la generazione, elettricità a 0,18 $/kWh e 2,95 $ per milione di token di output hosted. Questi input sono illustrativi. Sostituiscili con preventivo, potenza misurata, tariffa elettrica e prezzi del provider.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Con otto ore di generazione senza interruzioni al giorno, lo stesso calcolo richiede circa 291 giorni. Otto ore con un assistente aperto differiscono da otto ore di generazione dei token.
Con un prezzo hosted di 0,16 $ per milione di output, l’elettricità locale in questo scenario costa già più dell’hosting. In queste ipotesi non esiste un punto di pareggio positivo basato solo sull’output.
Usa i prezzi correnti dei modelli OpenRouter del provider scelto, inclusi costi di input e input in cache. Misura l’energia dell’intero sistema, incluso il prefill. Aggiungi upgrade, energia a riposo, manutenzione e valore di rivendita previsto. Confronta il lavoro accettato, perché retry e differenze di qualità cambiano il costo per compito.
Quando aggiungere memoria
Vai oltre 16GB quando il carico misurato supera il contesto disponibile con qualità e latenza accettabili. Lunghe sessioni quotidiane di agenti, richieste simultanee o pesi a precisione maggiore rendono utile una capacità superiore.
Due schede da 16GB richiedono supporto esplicito del runtime. Non diventano un’allocazione trasparente da 32GB. Ogni dispositivo richiede buffer e la comunicazione usa l’interconnessione dell’host.
| Strategia di divisione | Compromesso principale |
|---|---|
| Divisione dei layer | Layer diversi occupano dispositivi diversi |
| Divisione tensoriale o per righe | Il lavoro nei layer aggiunge comunicazione |
| CPU più GPU | Più capacità con un profilo di latenza diverso |
Una seconda scheda merita attenzione quando scheda madre, alimentatore, raffreddamento e backend supportano già il piano. Confronta il costo completo del sistema con una singola GPU più grande. La guida hardware Qwen da 32GB tratta queste alternative.
Risoluzione dei problemi e prossimi passi
Se il caricamento fallisce, riduci il contesto e controlla le allocazioni. Se la velocità cala durante una sessione, controlla contesto occupato e offload sulla CPU. Se la prima risposta si blocca, misura il prefill freddo. Se l’uso degli strumenti si rompe dopo la compressione, confronta lo stesso compito con un modello a precisione maggiore.
Salva un test ripetibile con istruzioni normali, file e output degli strumenti. Registra revisione del modello, versione del runtime, precisione della cache, contesto occupato, memoria di picco, latenza del primo token, velocità di decode e superamento del compito. Ripeti vicino alla sessione più lunga prevista.
Usa la guida a modelli locali e contesto per confrontare alternative più piccole. Scegli il modello più piccolo che soddisfa i requisiti di qualità, poi riserva abbastanza memoria per il compito completo. In queste condizioni, 16GB sono un obiettivo utile per una workstation.
Related Posts