Dentro la nostra flotta ibrida di agenti IA: Hermes, LiteLLM e Tailscale

Table of Contents
Abbiamo distribuito una flotta GPU locale con assegnazione legata alla richiesta e progettato il suo piano di controllo ibrido. Il percorso verificato parte da LiteLLM, seleziona un gruppo di modelli e carica un modello locale su una sola GPU per volta. La policy a livelli di Hermes è proposta. Un artefatto di configurazione Tailscale Aperture è pronto per il prossimo test d’integrazione. Nessuno dei due è stato verificato come parte di un unico percorso end-to-end.
Le schede inattive minano Pearl. Una richiesta IA sospende il mining solo sulla scheda in leasing, gestisce la richiesta, scarica il modello e restituisce la scheda al miner.
Punti chiave
- T0-T2 gestiscono il lavoro oneroso o impegnativo. Questi percorsi privilegiano modelli frontier ospitati e catene di fallback ordinate.
- T3 gestisce una parte sostanziale del lavoro locale. La flotta assegna pianificazione, codice, revisione e visione a modelli da 4B a 12B.
- T4 gestisce attività locali frequenti e numerose. I modelli piccoli instradano, classificano, estraggono, creano embedding e completano attività di codice circoscritte.
- Ogni GPU è una risorsa indipendente. Una scheda serve le richieste IA mentre le altre continuano a minare.
- I modelli locali restano scaricati quando sono inattivi. Nessun modello occupa memoria GPU tra le finestre di richiesta.
- Ogni gateway espone lo stesso catalogo logico. Gli alias condivisi distribuiscono il lavoro sui sistemi idonei. Gli alias con prefisso del nodo mantengono il posizionamento esatto quando necessario.
- Il broker sperimentale non è entrato in produzione. Il suo canary ha servito una richiesta, poi ha fallito un test di arresto pulito. LiteLLM è rimasto sul percorso verificato per richiesta.
- Hermes e Aperture sono ancora in preparazione. Il design obiettivo esiste, mentre i test di accettazione end-to-end sono ancora aperti.
Prerequisiti: diversi host Linux con GPU, driver NVIDIA stabili, un tailnet Tailscale, systemd, un miner operativo, spazio per i modelli e test di accettazione per ogni percorso modello.
Tempo e difficoltà: avanzato. Dedica diversi giorni a inventario, download dei modelli, definizioni dei servizi, test di routing, prove di guasto e verifiche del ripristino del mining per scheda.
Termini usati qui: un tailnet è la rete privata formata da identità e dispositivi Tailscale. Un alias modello è un nome stabile presentato ai client. Un gruppo di modelli colloca più distribuzioni dietro un alias. Un proxy del pool è un piccolo servizio locale che prende in leasing una GPU, avvia il worker del modello e poi restituisce la scheda al mining.
Obiettivo del design
Il lavoro degli agenti ha forme diverse. Riparare un repository richiede un modello diverso da quello per un titolo, uno screenshot, un embedding o un’etichetta d’intento. Inviare ogni turno al modello più grande spreca denaro e capacità locale. Inviare ogni turno al più piccolo genera ripetizioni e risultati deboli.
Volevamo un catalogo con cinque fasce di carico. La policy doveva servire modelli ospitati e locali con formati API familiari. Le GPU locali dovevano restare produttive tra una richiesta IA e l’altra.
Serviva anche la concorrenza. Un host con più schede doveva gestire più lavori indipendenti nello stesso momento. Una richiesta su una scheda non doveva fermare il mining su tutte le altre del telaio.
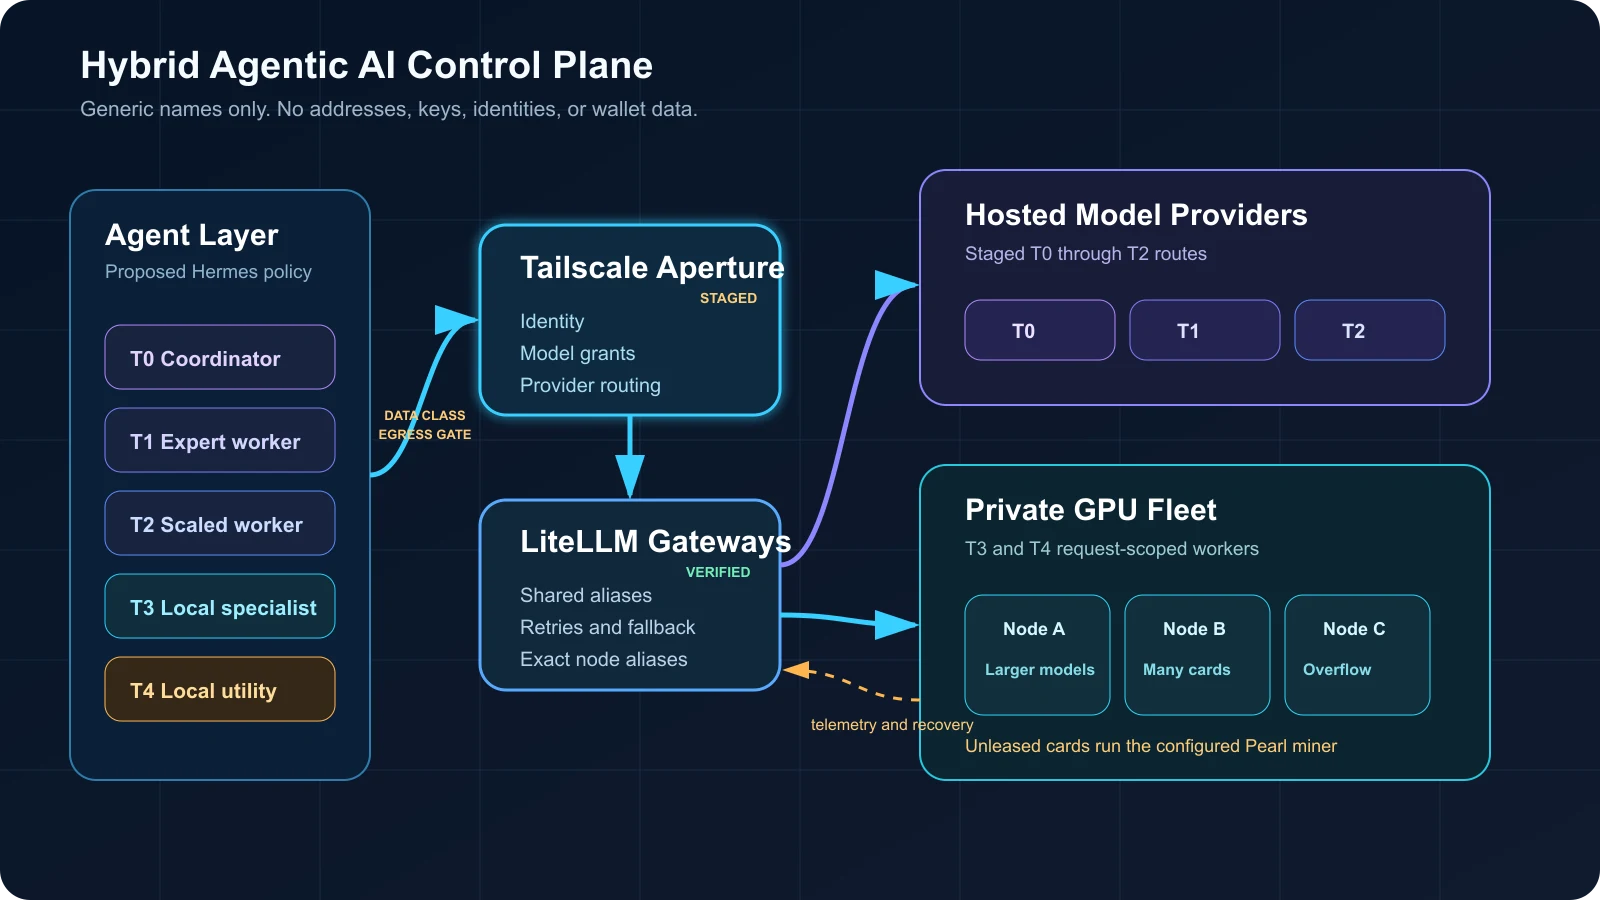
Il percorso di controllo proposto e predisposto si trova sopra il percorso verificato LiteLLM e di esecuzione per GPU
Il diagramma usa nomi generici per i nodi. Omette indirizzi privati, identità utente, chiavi di accesso, dati del wallet ed etichette degli host fisici.
Cosa significano T0-T4
I nomi dei livelli sono la nostra policy di routing. Non sono uno standard di settore e non descrivono solo le dimensioni del modello.
| Livello | Ruolo principale | Destinazione tipica | Comportamento in caso di errore |
|---|---|---|---|
| T0 | Coordinatore predefinito e decisioni più difficili | Modello frontier ospitato per il ragionamento | Catena di fallback ospitata ordinata |
| T1 | Agenti worker ad alto valore | Pool ospitato di modelli ad alte capacità | Nuovo tentativo nella catena assegnata |
| T2 | Pool ampio di agenti worker | Modelli ospitati veloci, con escalation | Escalation dei compiti difficili a T1 o T0 |
| T3 | Lavoro locale privato sostanziale | Modelli locali da 4B a 12B per chat, codice, revisione e visione | Nuovo tentativo su un nodo locale idoneo, poi arresto sicuro per dati riservati |
| T4 | Lavoro locale frequente e circoscritto | Modelli da 0,6B a 3B per routing, classificazione, codice ed embedding | Nuovo tentativo su una replica locale oppure passaggio a T3 entro lo stesso confine dei dati |
I livelli descrivono prima il lavoro e poi il modello. Una classificazione breve e sensibile alla sicurezza rientra in T4. Un piano lungo per un repository rientra in T3 o superiore. Una difficile decisione architetturale parte da un livello più alto anche con un prompt breve.
Questa suddivisione cambia anche l’economia degli agenti. I worker T4 assorbono trasformazioni ripetute a basso rischio. I worker T3 mantengono le attività comuni di codice e analisi nel tailnet. T0-T2 restano disponibili per il lavoro difficile e il ripristino dopo un guasto.
Un controllo della classe dei dati deve precedere ogni fallback ospitato. I lavori pubblici, interni e riservati usano catene separate. Il lavoro riservato resta locale e si arresta in sicurezza. Un nuovo tentativo oltre un confine richiede input sanificati e l’approvazione esplicita dell’utente o del flusso di lavoro. Prima di qualsiasi chiamata ospitata, la redazione rimuove credenziali, segreti del repository, output privato degli strumenti e contenuti sensibili recuperati.
Come Hermes gestirà la policy delle attività
Hermes è il livello agentico proposto. La policy obiettivo assegna una classe di modello, esegue strumenti, delega il lavoro e percorre catene di fallback esplicite. Hermes documenta percorsi separati per modello principale, attività ausiliarie, agenti delegati e fallback specifici per attività. Supporta anche endpoint personalizzati compatibili con OpenAI tramite un URL di base. Consulta la guida alla configurazione di Hermes e la guida ai provider di fallback .
La nostra policy associa le attività Hermes ad alias stabili invece che ai server fisici. Esempi:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
L’alias esprime l’intento. Hermes non deve sapere quale GPU è libera, quale nodo ha una scheda più grande o quale replica non ha superato il controllo di integrità. Le decisioni spettano ai livelli inferiori.
Alcuni lavori richiedono ancora un posizionamento deterministico. Un ID modello con prefisso del nodo indirizza una diagnosi o un benchmark dell’operatore a un sistema scelto. Autorizzazioni Aperture separate dovrebbero limitare questi alias agli operatori. Il normale traffico degli agenti usa alias condivisi per livello.
L’accesso al modello non protegge gli strumenti dell’agente. Il rollout Hermes richiede allowlist di strumenti con privilegi minimi, workspace isolati, credenziali circoscritte, controlli dell’uscita di rete e gestione delle prompt injection. I worker delegati non dovrebbero ereditare più accesso di quanto richieda l’attività assegnata.
Aperture come confine d’identità predisposto
Tailscale connette il gateway configurato e gli host d’inferenza senza pubblicare ogni servizio su Internet. Aperture è predisposto come confine visibile all’utente e router dei modelli. Questo percorso richiede ancora un test di accettazione end-to-end. Tailscale documenta l’accesso client cifrato sul tailnet e l’inoltro TLS al provider in Come funziona Aperture .
Aperture separa anche raggiungibilità e autorizzazione. I grant negano l’accesso per impostazione predefinita. Dopo aver raggiunto il gateway, un utente o dispositivo taggato deve avere un grant modello corrispondente. La guida ai grant Aperture illustra il modello additivo e le fonti d’identità.
Prima della distribuzione, la configurazione Aperture predisposta deve seguire quattro regole:
- Una sola identità nominativa detiene il ruolo di amministratore. L’accesso generale ai modelli non concede privilegi amministrativi.
- I provider elencano ID modello letterali. Aperture non deduce i modelli da un servizio upstream.
- Gli URL dei provider puntano agli indirizzi del tailnet. Nomi e indirizzi dei nodi privati non devono comparire nell’articolo né negli esempi di configurazione pubblici.
- I segreti restano in file di proprietà del servizio. Prima della distribuzione applica permessi riservati al proprietario, account di servizio limitati, rotazione e redazione dei log. L’output diagnostico non deve mai stampare chiavi LiteLLM, indirizzi tailnet, token di abbonamento o dati del wallet.
Aperture aggiunge il percorso della richiesta in ingresso all’URL base di ogni provider. La
guida di configurazione
avverte di non includere un suffisso /v1 duplicato nella radice del provider. Questo dettaglio ha creato abbastanza rischio d’integrazione da giustificare un controllo esplicito.
La visione è predisposta per usare il formato OpenAI Chat Completions con contenuti immagine. Gli embedding usano direttamente l’endpoint LiteLLM privato, perché la matrice attuale dei provider self-hosted di Aperture documenta formati chat, mentre il nostro percorso di embedding dipende dagli endpoint LiteLLM e llama.cpp fuori dal selettore chat. Consulta la referenza dei provider e client supportati .
Il percorso diretto degli embedding richiede un proprio confine di autorizzazione. Autenticazione LiteLLM, grant Tailscale restrittivi, binding del servizio all’interfaccia tailnet e regole firewall dell’host devono limitare l’accesso alle identità o ai tag di servizio approvati. Un indirizzo privato da solo non costituisce una policy di autorizzazione.
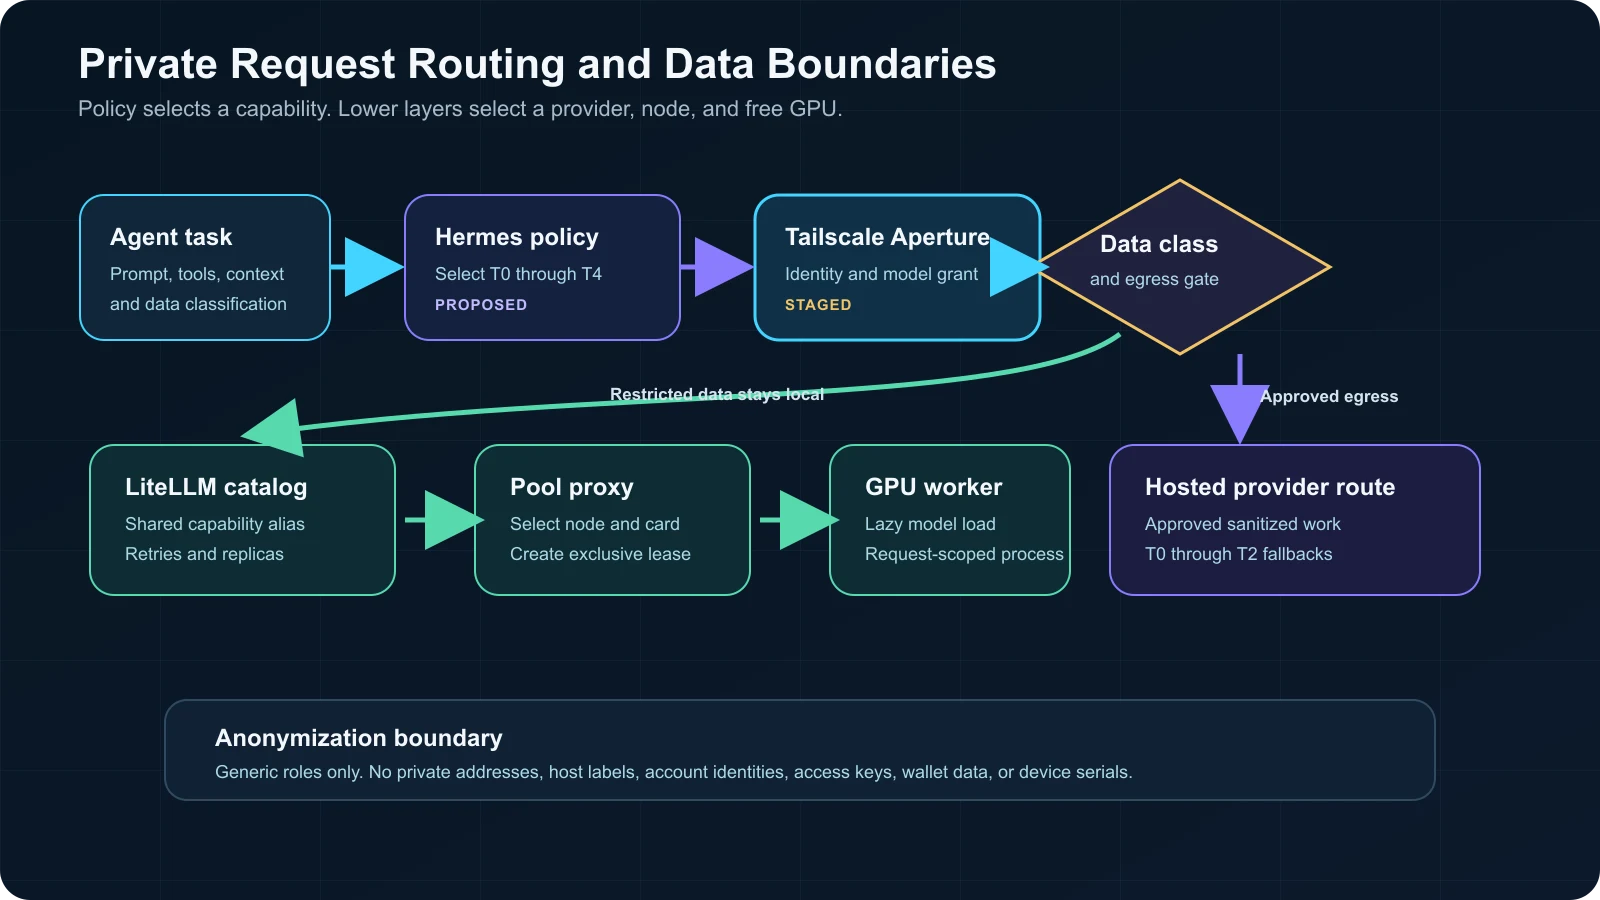
Identità, grant e classificazione dei dati decidono se una richiesta lascia la flotta privata
LiteLLM presenta un unico catalogo
Ogni host d’inferenza esegue un gateway LiteLLM. Tutti i gateway espongono lo stesso catalogo logico di modelli, anche se un modello è su un altro nodo. Il client mantiene un unico formato API e un unico insieme di alias.
LiteLLM raggruppa più distribuzioni sotto un solo nome modello. Il router sceglie quindi una distribuzione idonea e applica nuovi tentativi, timeout, periodi di cooldown o fallback. La documentazione attuale del routing LiteLLM descrive nomi modello condivisi, strategie di routing e comportamento dei tentativi.
Il catalogo usa due stili di indirizzo:
| Stile di indirizzo | Esempio | Uso |
|---|---|---|
| Alias condiviso | t4-classify | Distribuire il lavoro ordinario sui nodi idonei |
| Alias nodo | node-b/qwen-small | Eseguire diagnosi o mantenere il posizionamento |
Gli alias condivisi permettono la scalabilità orizzontale senza modificare Hermes. Aggiungere una replica idonea estende il gruppo. Rimuovere una replica non sana restringe il gruppo.
Manteniamo la logica del ciclo di vita GPU sotto LiteLLM. Il gateway resta caldo perché il suo ingombro di memoria non riserva memoria GPU. Un proxy locale del pool riceve la richiesta per il modello selezionato, prende in leasing una scheda, avvia il worker e lo arresta dopo la risposta.
Catalogo dei modelli locali
La flotta privilegia modelli fino a 12B parametri. Questo limite corrisponde alla memoria disponibile sulle schede e lascia spazio al contesto e ai buffer di runtime.
Notazione modelli: B indica miliardi di parametri. K indica migliaia di token di contesto configurati. La quantizzazione memorizza i pesi con precisione numerica ridotta per contenere la memoria. La cache KV mantiene lo stato di attenzione del contesto attivo e cresce con la lunghezza del prompt. E4B è l’etichetta di Google per la variante più piccola di Gemma 4.
| Percorso livello | Classe modello | Contesto configurato | Attività principale | Posizionamento |
|---|---|---|---|---|
| T3 smart | Qwen3.5 9B, quantizzato | 64K | Pianificazione locale difficile e lavoro generale degli agenti | Nodi GPU con più memoria |
| T3 codice | Granite 4.2 8B, quantizzato | 64K | Lavoro sui repository, strumenti, terminale e output strutturato | Nodi GPU con più memoria |
| T3 revisione | Gemma 4 12B, quantizzato | 32K | Revisione indipendente e ragionamento alternativo | Nodi GPU con più memoria |
| T3 generale e visione | Qwen3.5 4B, quantizzato | 32K | Lavoro generale scalabile e comprensione delle immagini | Ogni GPU compatibile |
| T3 revisione alternativa | Gemma 4 E4B, quantizzato | 8K | Percorso di revisione diversificato | Ogni GPU compatibile |
| T4 codice | Granite 4.2 3B, quantizzato | 16K | Piccole modifiche, chiamate agli strumenti e output strutturato | Ogni GPU compatibile |
| T4 classificazione | Qwen3.5 2B, quantizzato | 16K | Classificazione, estrazione e riscrittura | Ogni GPU compatibile |
| T4 router | Qwen3.5 0.8B, quantizzazione ad alta precisione | 16K | Intento, etichette, titoli e trasformazioni brevi | Ogni GPU compatibile |
| T4 embedding | Qwen3 Embedding 0.6B, quantizzato | 32K | Memoria agenti, RAG, recupero codice e clustering | Ogni GPU compatibile |
Questi valori di contesto sono impostazioni di distribuzione, non i limiti pubblicizzati dei modelli. Una finestra pubblicizzata più ampia continua a consumare cache KV e memoria di runtime. Abbiamo scelto valori più bassi per garantire un servizio stabile su una sola scheda.
Qwen descrive Qwen3.5 come famiglia multimodale e pubblica varianti dense da piccole a grandi nella raccolta Qwen3.5 . IBM pubblica risultati di coding agentico e contesto lungo per Granite 4.2 8B . Google elenca input multimodale, chiamata di funzioni e una finestra pubblicizzata più ampia per Gemma 4 .
Il percorso embedding usa un modello separato invece di chiedere vettori a un modello chat. La scheda Qwen3 Embedding 0.6B elenca sequenza di 32K, recupero multilingue e del codice, e dimensioni di output fino a 1.024.
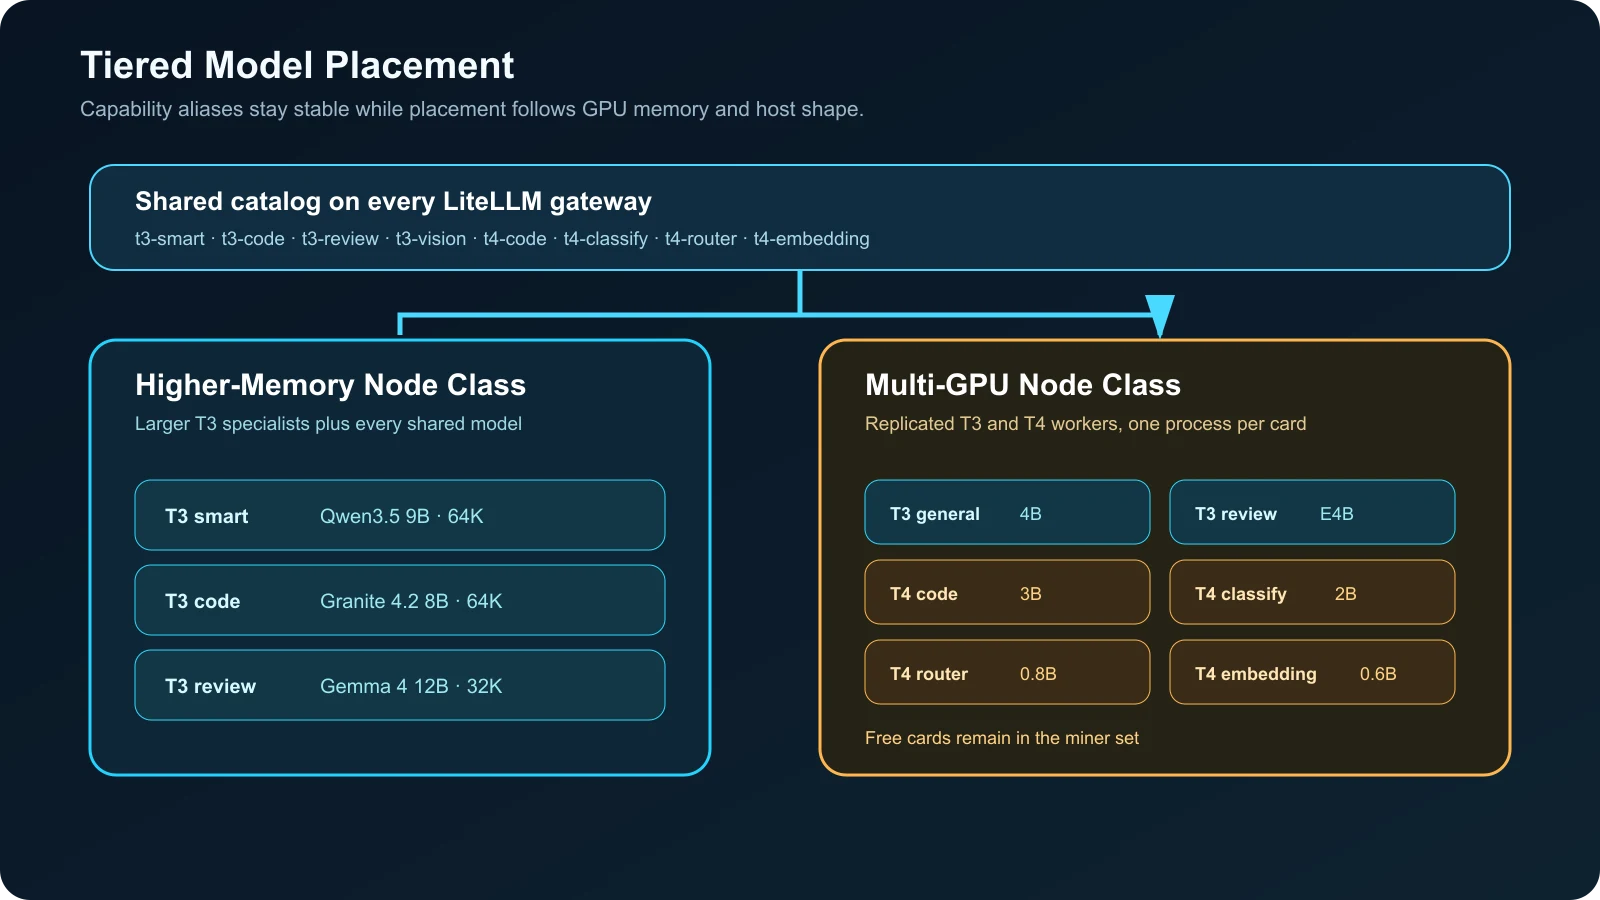
Gli specialisti più grandi restano sulle schede con più memoria, quelli piccoli si replicano nella flotta
Perché llama.cpp è in produzione
llama.cpp corrisponde al modello delle risorse. Un worker statico mappa una GPU, un file modello, un contesto configurato e un leasing. Il confine di processo rende facile controllare avvio, arresto, visibilità GPU e log.
Il server espone chat, risposte ed embedding compatibili con OpenAI. Supporta anche decodifica parallela e continuous batching. La documentazione attuale del server definisce sperimentale il supporto multimodale. Queste funzioni sono nella documentazione del server llama.cpp .
Ollama resta disponibile come percorso di compatibilità su un nodo più grande. Supporta caricamenti simultanei quando c’è memoria sufficiente e scaricamento immediato con keep_alive: 0, come documentato nelle
FAQ Ollama
. Non abbiamo scelto Ollama per il percorso di produzione per scheda perché i worker statici llama.cpp offrivano maggiore controllo su posizionamento e arresto.
Abbiamo anche valutato Strata. Strata è destinato a un grande modello Qwen mixture-of-experts distribuito tra memoria GPU, RAM di sistema e archiviazione. Le configurazioni pubblicate partono da 32 GB di memoria combinata; la modalità low-RAM scambia velocità per minore capacità. Vedi il repository Strata . Strata soddisfa un obiettivo diverso: un singolo modello ibrido più grande su una o più schede. La nostra flotta privilegia molti worker indipendenti sotto 12B.
Caricamento su richiesta per GPU
Il caricamento su richiesta si applica a ogni worker modello. Tra le richieste il sistema mantiene attivi solo gateway, proxy del pool, watchdog e miner.
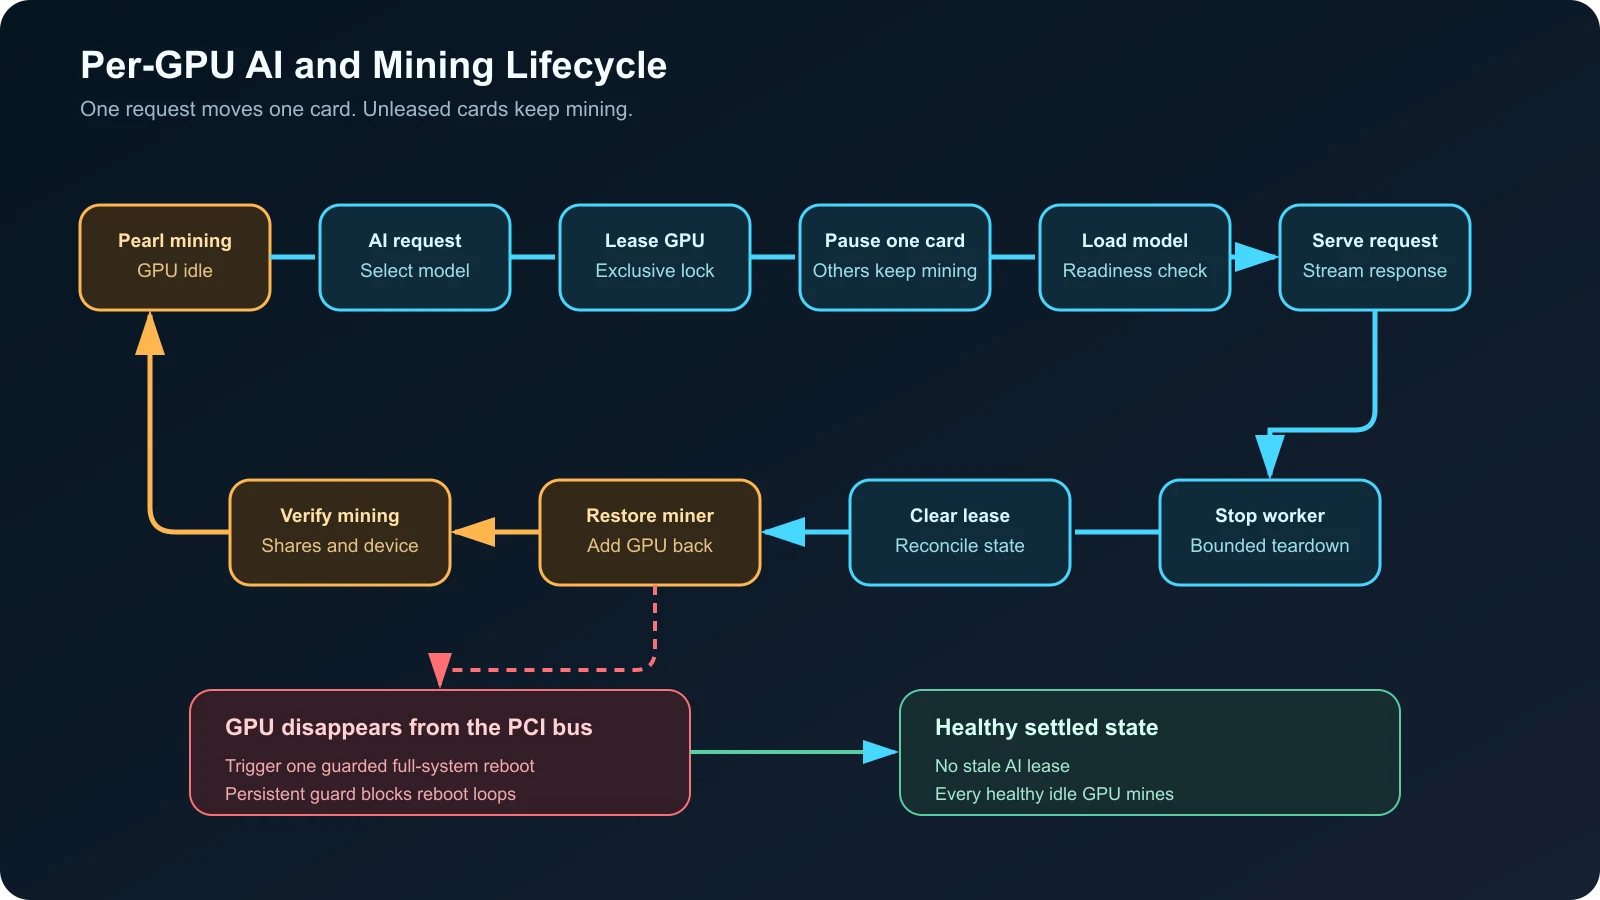
Solo la scheda presa in leasing lascia il miner e vi torna dopo la chiusura del processo modello
Il ciclo della richiesta segue questi passaggi:
- LiteLLM seleziona una distribuzione. La richiesta raggiunge un proxy del pool per la classe modello scelta.
- Il pool acquisisce un leasing. Un lock impedisce a due worker esclusivi di usare la stessa scheda.
- Il miner si riavvia senza una GPU. Ogni scheda non in leasing resta nel comando Pearl.
- llama.cpp si avvia sul dispositivo in leasing. I controlli di readiness terminano prima che il proxy inoltri la richiesta.
- Il worker serve la risposta. Le richieste simultanee avviano worker su altre schede libere.
- Il worker termina. Il pool rimuove il leasing dopo l’arresto del processo.
- Il miner si riavvia con la GPU liberata. I controlli di integrità confermano il rientro della scheda nel mining.
È diverso da uno scambio totale dell’host. Un telaio con più schede serve più modelli mentre le altre schede continuano a minare. Una flotta inattiva restituisce ogni GPU sana a Pearl.
Il whitepaper Pearl descrive il suo sistema di prova per calcoli matriciali. La nostra architettura non dipende da previsioni di redditività o affermazioni di rendimento economico. Il mining è il carico inattivo configurato.
La gestione dei guasti conta più dell’avvio
L’avvio del modello è solo metà del ciclo di vita. Arresti forzati, GPU scomparse, richieste interrotte, leasing obsoleti e riavvii del miner richiedono una gestione esplicita.
Il watchdog confronta l’insieme GPU configurato con l’elenco live dei dispositivi NVIDIA. Una GPU confermata mancante attiva un singolo riavvio completo del sistema con protezioni. Un trigger di produzione sicuro dovrebbe richiedere controlli ripetuti falliti, un cooldown, svuotamento delle attività in corso, contatore persistente dei riavvii e avviso remoto. Un recupero fallito dovrebbe fermare l’automazione e richiedere intervento manuale.
Lo stesso watchdog riconcilia i leasing obsoleti. Se nessun worker possiede un leasing, la riconciliazione rimuove il record obsoleto e restituisce la GPU al miner. Questo percorso di recupero è stato importante durante il canary del broker.
| Guasto | Risposta |
|---|---|
| Il modello non è pronto | Arrestare il worker, rilasciare il leasing, ripristinare il mining e restituire un errore |
| La richiesta termina inaspettatamente | Limitare il tempo di pulizia, terminare l’albero dei processi e riconciliare il leasing |
| Una GPU scompare | Confermare mancanze ripetute, svuotare il lavoro attivo, avviare un riavvio protetto, inviare un avviso e verificare l’intero set GPU configurato |
| Il miner omette una scheda inattiva | Ricostruire l’elenco dispositivi dai leasing attivi e riavviare il miner |
| Una distribuzione LiteLLM fallisce | Provare un’altra replica nello stesso gruppo, quindi applicare la policy di fallback |
| Un grant Aperture blocca un percorso | Correggere identità o grant modello, mai aggirare la policy gateway |
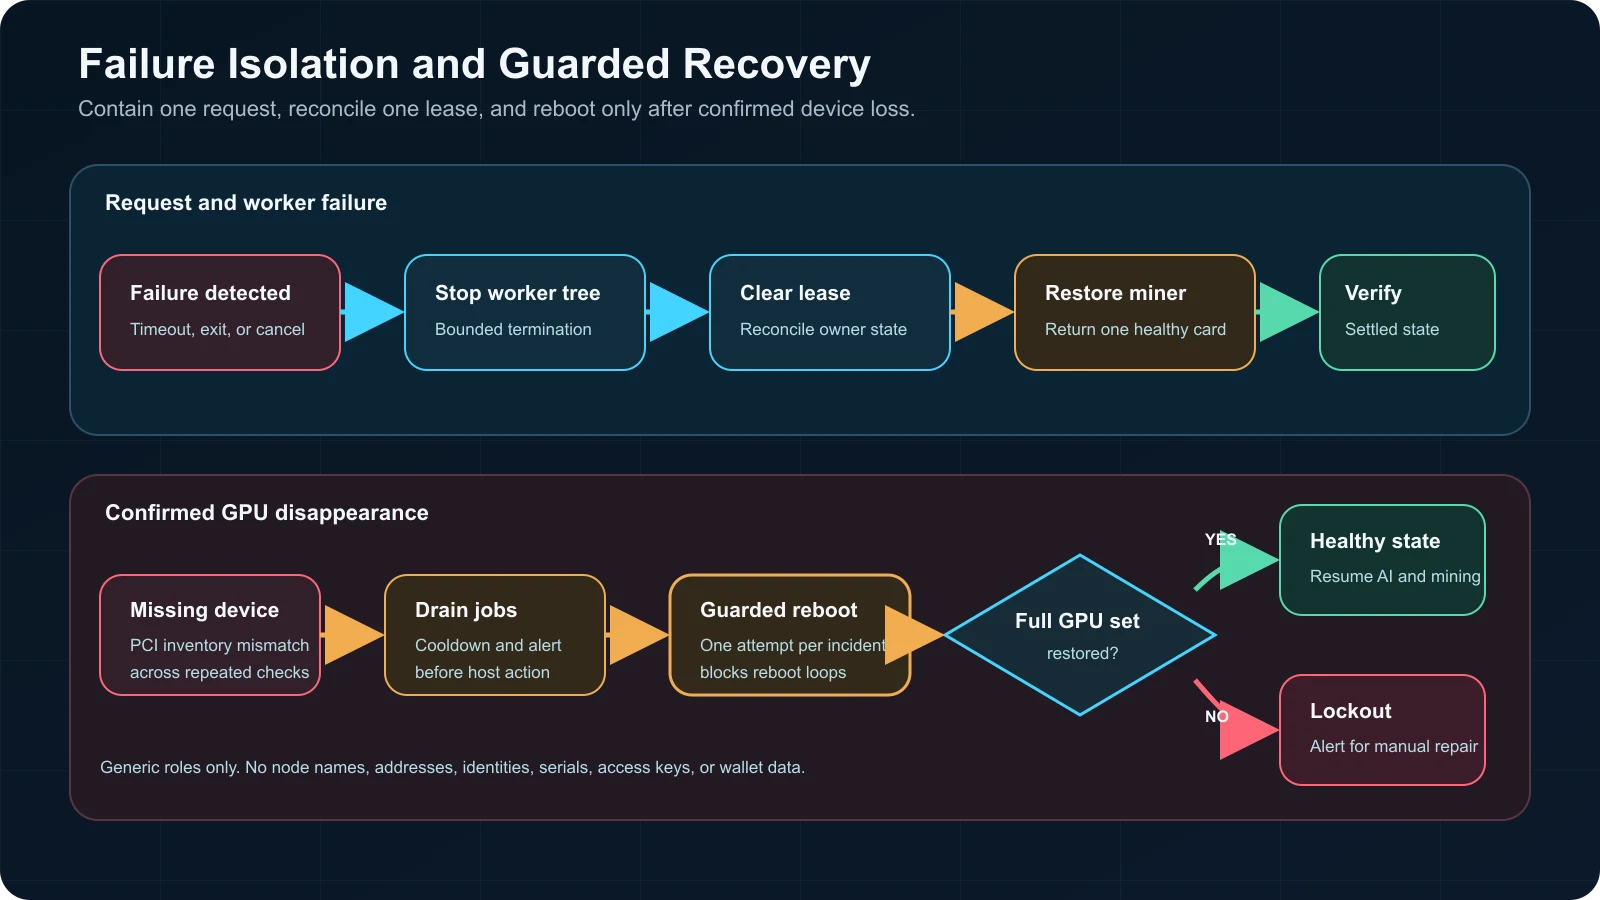
I guasti ordinari rilasciano un leasing, la perdita confermata di un dispositivo avvia il percorso protetto di ripristino host
Cosa è successo con il broker sperimentale
Il broker indipendente dal backend punta a presentare un’unica interfaccia compatibile con OpenAI per Ollama, vLLM, llama.cpp e Strata. Include gestione del ciclo di vita per modello, scaricamento in inattività e posizionamento GPU.
Abbiamo testato la versione 0.6.0 del broker al commit c12b65 il 21 ottobre 2026. La suite locale ha riportato 1.101 test superati e 2 saltati, con Ruff pulito. Il canary ha quindi caricato un modello su richiesta e servito una richiesta chat riuscita. Le altre GPU hanno continuato a minare durante la richiesta.
L’arresto ha rivelato un problema critico del ciclo di vita. Dopo il caricamento, il broker è rimasto nella procedura di stop finché systemd non ha terminato l’albero dei processi. L’arresto forzato ha lasciato un leasing GPU obsoleto finché la riconciliazione non ha ripristinato il miner. Abbiamo inoltre trovato una lacuna tra l’impostazione documentata delle GPU richieste e l’applicazione nell’adapter di produzione.
Abbiamo disabilitato il broker nel percorso di produzione. LiteLLM instrada ora tramite il proxy del pool per richiesta. Il broker resta sperimentale finché i test d’integrazione non superano arresto limitato dei processi figlio, terminazione dei gruppi di processi, controlli di ammissione GPU obbligatoria e pulizia dei leasing obsoleti.
Questo risultato offre una lezione tecnica utile. Un broker dimostra poco se avvia un modello una sola volta. La prontezza per la produzione dipende da arresto pulito, ripristino limitato, ammissione esclusiva dei dispositivi e prove di guasto ripetibili.
Verifiche eseguite
Il test di distribuzione ha coperto più di una risposta del modello:
- Ogni modello chat condiviso ha completato caricamento, risposta, uscita e ripristino Pearl su almeno un host idoneo.
- Vision ha accettato input immagine tramite il percorso chat.
- Gli embedding hanno restituito la dimensione vettoriale configurata tramite il percorso LiteLLM privato.
- Più modelli hanno funzionato contemporaneamente su schede separate.
- Le schede non in leasing sono rimaste nel miner durante richieste IA concorrenti.
- Gli alias condivisi hanno instradato il traffico tra i nodi idonei.
- Gli alias con prefisso nodo hanno mantenuto il posizionamento deterministico.
- Ogni gateway LiteLLM ha elencato lo stesso catalogo logico.
- Una GPU mancante è stata ripristinata dopo un riavvio completo dell’host. Il watchdog ora ha una protezione persistente dai loop.
- Un errore di arresto del broker è stato recuperato con la riconciliazione del leasing.
- Lo stato finale stabilizzato non mostrava leasing IA e ogni GPU sana era tornata nel set del miner.
I controlli di integrità e gli elenchi di modelli non sono stati considerati test di caricamento. Un test di accettazione utile invia una richiesta reale, controlla la risposta, conferma la GPU scelta, osserva l’arresto e verifica il ripristino del mining.
Risoluzione dei problemi della flotta
| Sintomo | Primo controllo |
|---|---|
| Il modello appare ma le richieste falliscono | ID modello upstream, formato API, header di autenticazione e URL base provider |
| Aperture restituisce 405 | La radice provider non ha un suffisso /v1 duplicato |
| La richiesta raggiunge il nodo sbagliato | Alias condiviso o alias con prefisso nodo |
| Due worker puntano alla stessa scheda | Lock leasing, stato leasing obsoleto e logica di ammissione GPU |
| Il mining si ferma su tutte le schede | Il codice di riavvio del miner costruisce la lista dispositivi dai leasing attivi |
| Una GPU resta fuori dal mining | Albero dei processi worker, riconciliazione leasing e lista dispositivi miner |
| Il caricamento a freddo è lento | Dimensione modello, velocità storage, larghezza PCIe e pressione CPU host |
| I prompt lunghi falliscono | Contesto configurato, margine cache KV e riserva output |
| Il percorso embedding manca in Aperture | Usa il percorso LiteLLM autenticato, limitato dall’identità Tailscale e dalle policy firewall host |
| Lo stop del broker resta bloccato | Disabilita il percorso broker e riporta il traffico al proxy pool verificato |
Regole di design da mantenere
- Instrada in base allo scopo del lavoro. La dimensione modello da sola non definisce un livello.
- Tieni la policy sopra il posizionamento. Hermes sceglie un alias di capacità. LiteLLM sceglie una distribuzione. Il pool sceglie una GPU.
- Tratta ogni GPU come leasing indipendente. Lo scambio sull’intero host spreca le schede disponibili.
- Scarica ogni modello inattivo. Gateway attivi non richiedono worker GPU caldi.
- Mantieni un percorso limitato a posizionamento esatto. Gli alias nodo riservati agli operatori rendono riproducibili le diagnosi.
- Testa prima l’arresto. Ripristino del miner e pulizia dei leasing appartengono ai test di accettazione.
- Separa chat, visione ed embedding. Un gateway non implica un solo percorso di protocollo.
- Tieni i dettagli privati fuori dai diagrammi. Pubblica ruoli e flussi, non indirizzi, chiavi, identità o wallet.
- Proteggi la logica di riavvio. Richiedi mancanze ripetute, cooldown, contatore persistente, avviso e intervento manuale dopo un ripristino fallito.
- Mantieni una via sperimentale separata. Un broker guasto non deve trascinare con sé il percorso verificato.
Prossimi passi
La fase successiva valuta i carichi. Ogni livello richiede un insieme fisso di attività, criteri di accettazione, registrazioni di latenza, occupazione GPU, tempo d’interruzione del mining e tassi di escalation. Queste misure mostreranno quali attività T2 appartengono a T3 e quali T3 rientrano in T4.
Pianifichiamo anche il primo test di accettazione Hermes attraverso Aperture attraverso LiteLLM, poi ripeteremo i test del broker dopo le correzioni di arresto e ammissione GPU. La generazione di immagini richiede un adapter OpenAI compatibile e con caricamento su richiesta prima di unirsi allo stesso catalogo di routing.
Per dimensionare i modelli, leggi la guida a modelli IA locali e contesto GPU . Per i confini di privacy, leggi Privacy e sicurezza dell’IA locale . Per configurazione e rischi del miner, consulta la guida al mining Pearl invece di considerare il mining inattivo un profitto garantito.
Related Posts