
Certificazioni di cybersecurity AI: non tengono il passo

Table of Contents
Abbiamo sostenuto gli esami. Li abbiamo superati. Abbiamo ottenuto i certificati, ma anche una delusione che voglio descrivere con precisione.
Non è una critica alle persone che hanno creato questi programmi. Lavorano con materiali incompleti. La sicurezza AI è una disciplina giovane. La ricerca sugli attacchi avanza più rapidamente degli strumenti difensivi. I framework di governance sono arrivati prima delle indicazioni ingegneristiche.
Il problema è il divario tra ciò che insegnano le certificazioni e ciò che devi sapere per proteggere davvero i sistemi AI in produzione.
Tre livelli spesso confusi
Prima di spiegare cosa manca, è utile distinguere ciò che esiste oggi.
Il primo livello è la governance. Documenti come NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 e EU AI Act operano a livello organizzativo e di processo. Descrivono come gestire il rischio AI, strutturare la supervisione e documentare la responsabilità. Si concentrano intenzionalmente sulla governance, non sulla prescrizione dei controlli. È una scelta progettuale.
Il secondo livello è la tassonomia delle minacce. MITRE ATLAS documenta le tattiche avversarie contro i sistemi AI nello stesso formato di ATT&CK. OWASP Top 10 for Large Language Model Applications elenca le classi di attacco più rilevanti per gli LLM distribuiti. Questi documenti nominano gli attacchi e descrivono come funzionano. Non prescrivono le difese.
Il terzo livello è la guida tecnica. Include Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) e la documentazione di sicurezza specifica dei fornitori, tra cui Anthropic, OpenAI e Meta. Queste risorse forniscono indicazioni ingegneristiche su distribuzione sicura, pratiche di valutazione e controlli in fase di esecuzione.
La maggior parte delle certificazioni di governance AI copre a fondo il primo livello. Menziona il secondo a livello generale. Raramente tratta il terzo.
Cosa coprono le certificazioni
Le certificazioni di governance e sicurezza AI attualmente disponibili, tra cui IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, le certificazioni ISO 42001 e CompTIA AI+, coprono temi simili.
Impari il NIST AI RMF e come associare le sue quattro funzioni, Govern, Map, Measure e Manage, alla distribuzione AI della tua organizzazione. Impari la classificazione dei livelli di rischio dell’EU AI Act e come funziona la valutazione di conformità per i sistemi ad alto rischio. Studi pregiudizi, equità, trasparenza e responsabilità come principi di governance. Impari a scrivere politiche di governance AI e a condurre valutazioni d’impatto.
Sono competenze concrete. Le organizzazioni hanno bisogno di persone che comprendano i framework di governance, leggano il NIST AI RMF e capiscano cosa chiede loro di realizzare.
Le certificazioni non insegnano con la stessa profondità:
- Come gli aggressori compromettono oggi i sistemi AI in produzione
- Come funziona operativamente la difesa in profondità contro prompt injection e perché nessun controllo singolo la elimina
- Come verificare l’integrità dei modelli prima della distribuzione
- Cosa comporta il red teaming specifico per l’AI e come definirne l’ambito
- Come valutare il comportamento dei modelli rispetto a input avversari prima del lancio
- Come si presenta l’osservabilità AI al momento dell’inferenza
- In cosa la risposta agli incidenti AI differisce dai playbook IR standard
- Cosa serve per proteggere agenti AI con accesso agli strumenti e integrazioni esterne
Il NIST AI RMF riguarda la governance, non l’ingegneria
Il NIST AI RMF è un documento ben costruito. NIST lo ha progettato come neutrale rispetto alla tecnologia, indipendente dal settore e applicabile a diversi approcci allo sviluppo dell’AI. Questo rende il framework ampiamente applicabile.
Significa anche che non prescrive controlli tecnici per classi di attacco specifiche. Se la tua organizzazione adotta interamente l’AI RMF e associa tutte le sue funzioni alla distribuzione AI, avrai processi di gestione del rischio documentati. Non avrai necessariamente una difesa contro prompt injection sul modello linguistico distribuito.
NIST lo riconosce. NIST AI 600-1, Generative AI Profile, pubblicato nel 2024, estende l’AI RMF specificamente all’AI generativa e ai grandi modelli linguistici. Copre rischi come prompt injection, avvelenamento dei dati e pericoli informativi con un livello di dettaglio che il framework AI RMF di base non raggiunge. Se la tua certificazione ha trattato il framework di base senza AI 600-1, hai perso il documento più pertinente per i sistemi distribuiti oggi.
ISO 42001 e il confronto con i sistemi di gestione
ISO 42001:2023 è uno standard per i sistemi di gestione AI. Fornisce una struttura per governare lo sviluppo e la distribuzione dell’AI a livello organizzativo. I professionisti della sicurezza riconosceranno il parallelo con ISO 27001 per la sicurezza delle informazioni.
ISO 27001 è ampiamente adottato. Anche le organizzazioni certificate subiscono intrusioni. La certificazione documenta che esiste un sistema di gestione, che segue un processo definito e che viene riesaminato. Non certifica che i sistemi gestiti tramite quel processo resistano agli attacchi diretti contro di loro.
ISO 42001 offre disciplina organizzativa. La certificazione comunica alle parti interessate che i processi AI sono documentati, riesaminati e soggetti a governance. Non dimostra che i modelli distribuiti producano risultati coerenti in condizioni avversarie, che gli agenti operino entro limiti di fiducia definiti o che i modelli affinati siano stati creati con dati di addestramento verificati.
È lo stesso divario di ISO 27001. Nella cybersecurity tradizionale abbiamo imparato a conviverci. Non dovremmo fingere che le certificazioni di governance AI lo colmino se condividono la stessa limitazione strutturale.
L’EU AI Act impone risultati senza specifiche ingegneristiche
L’EU AI Act classifica i sistemi AI per livello di rischio: inaccettabile (vietato), alto (valutazione di conformità richiesta), limitato (obblighi di trasparenza) e minimo (nessun requisito specifico).
I sistemi ad alto rischio, compresi quelli usati nelle infrastrutture critiche, nell’identificazione biometrica, nella selezione del personale, nell’istruzione e nelle forze dell’ordine, devono rispettare requisiti di documentazione tecnica, supervisione umana e robustezza. La legge richiede esplicitamente che siano robusti contro i tentativi di alterarne il comportamento mediante manipolazione avversaria.
Il requisito è nel testo di legge. L’atto specifica intenzionalmente i risultati invece dei controlli tecnici. Non esistono ancora metodi tecnici condivisi per dimostrare la robustezza avversaria in tutti i contesti di distribuzione, per ogni tipo di sistema e caso d’uso.
Le certificazioni basate sull’EU AI Act ti preparano a classificare i sistemi AI, scrivere documentazione tecnica e strutturare protocolli di supervisione. Ti preparano agli audit. Il lavoro ingegneristico per creare un sistema conforme ai requisiti di robustezza appartiene a una disciplina diversa da quella coperta oggi dalle certificazioni.
Cosa attacca davvero i sistemi AI
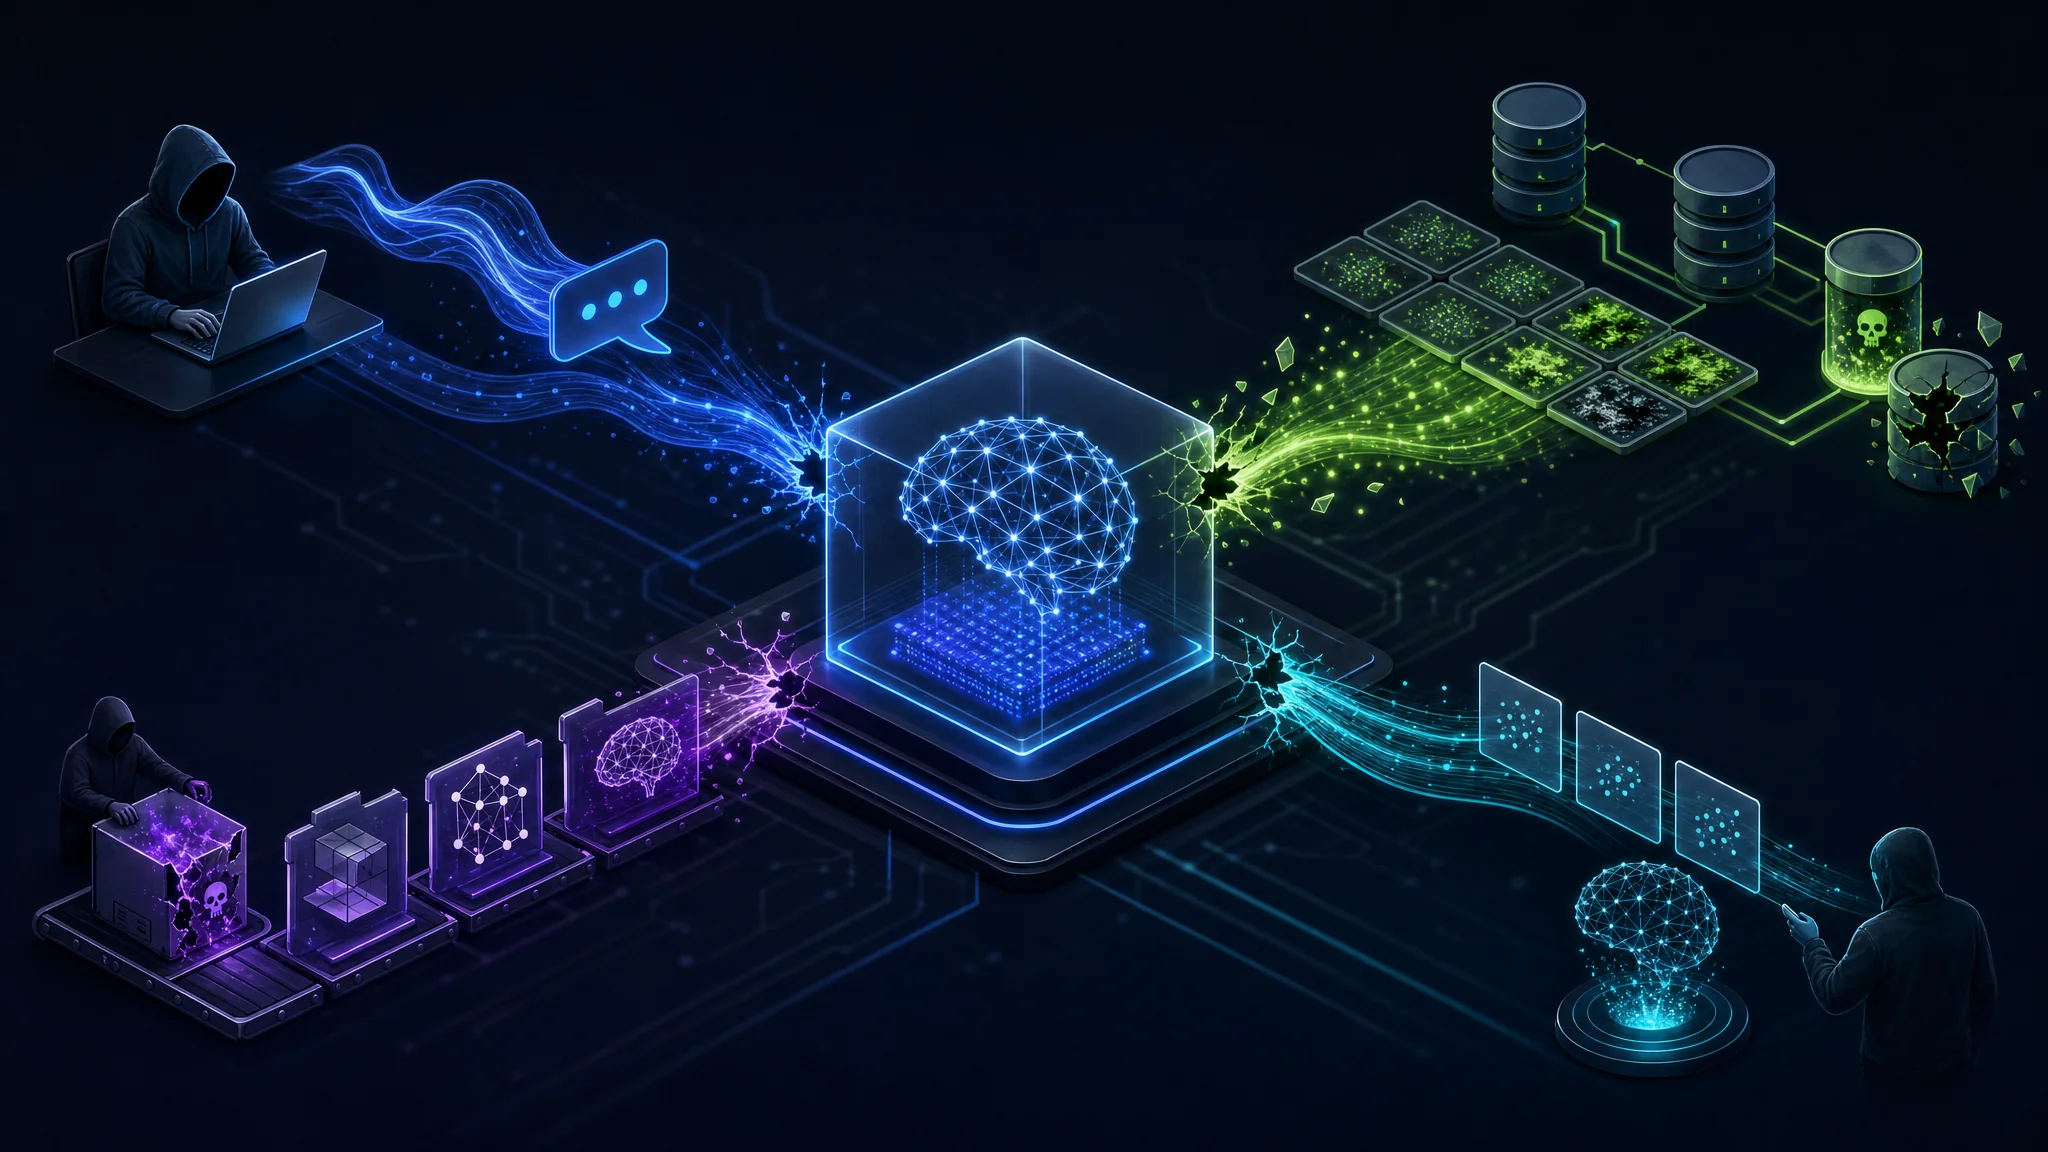
MITRE ATLAS e OWASP LLM Top 10 documentano il panorama operativo delle minacce. Sono risorse che elencano gli attacchi con un livello di dettaglio utile. I framework di governance citano le minacce in modo più astratto. Le informazioni seguenti provengono da queste fonti specialistiche di sicurezza.
Prompt injection fornisce a un modello linguistico un input che sovrascrive o manipola le istruzioni di sistema. L’iniezione diretta mira direttamente all’input del modello. Quella indiretta incorpora istruzioni malevole nei contenuti che il modello recupera, elabora o riassume. La tua pipeline RAG legge un documento controllato dall’aggressore ed esegue istruzioni nascoste. Il tuo agente di navigazione visita una pagina controllata dall’aggressore e ne segue le direttive. Il tuo bot di assistenza clienti riassume un articolo che gli dice di ignorare le linee guida di sicurezza.
Nel 2026 non esiste una mitigazione universalmente efficace per prompt injection. La difesa in profondità riduce il rischio con filtraggio degli input, validazione degli output, ambiti degli strumenti con privilegi limitati, ambienti di esecuzione isolati e approvazione umana per le azioni importanti. Nessuna di queste misure elimina la classe di attacco. NIST, OWASP, Anthropic, OpenAI, Google e Microsoft raccomandano controlli stratificati invece di una soluzione singola.
L’avvelenamento dei dati di addestramento inserisce esempi malevoli nei dati per degradare il comportamento del modello, introdurre backdoor o impiantare comportamenti attivati da trigger. Spesso non ci sono segnali di avvelenamento riuscito finché il modello non incontra input specifici. Se l’organizzazione affina modelli su contenuti generati dagli utenti, documenti recuperati o dataset di terze parti senza verificarne la provenienza, è esposta a questo rischio.
La compromissione della catena di fornitura dei modelli è una minaccia che molte organizzazioni considerano secondaria. I repository distribuiscono spesso codice eseguibile insieme ai pesi del modello. Formati di serializzazione non sicuri come pickle hanno creato ripetutamente rischi nella catena di fornitura. I pacchetti associati ai download dei modelli possono installare dipendenze vulnerabili. Molte organizzazioni sembrano esaminare i modelli dei repository pubblici molto meno attentamente delle dipendenze software. La superficie di attacco è comparabile a npm, ma la cultura della sicurezza in questo ambito è ancora agli inizi.
L’estrazione del modello consente agli aggressori di ricostruire modelli funzionalmente simili tramite query di inferenza ripetute alla tua API. Ciò comporta perdita di proprietà intellettuale e permette di studiare il modello offline per sviluppare attacchi più mirati.
L’inferenza di appartenenza consente agli aggressori di stabilire con diversi livelli di certezza se specifici dati fossero presenti nell’insieme di addestramento. Dipende dall’architettura del modello e dal regime di addestramento. Crea rischi di privacy per le organizzazioni che hanno addestrato modelli su informazioni personali.
Gli input avversari manipolano gli output del modello mediante perturbazioni costruite ad arte. La tecnica è più studiata nella classificazione delle immagini, ma si applica anche a testo, audio e sistemi multimodali. Se la tua AI decide su rilevamento delle frodi, affidabilità creditizia, immagini mediche o accesso fisico, la robustezza avversaria è una proprietà di sicurezza da testare, non soltanto da documentare.
Le fughe di dati dai sistemi AI meritano attenzione diretta. Le pipeline RAG espongono documenti della base di conoscenza, a volte a utenti che non dovrebbero accedervi. La fuga del prompt dalle istruzioni di sistema rivela dettagli operativi che volevi mantenere riservati. Le implementazioni AI multi-tenant richiedono isolamento, che gli ingegneri di sicurezza applicativa tradizionali a volte sottovalutano. Sono rischi operativi frequenti nei sistemi distribuiti.
Gli agenti AI cambiano completamente la superficie di attacco
La maggior parte delle certificazioni di sicurezza AI è stata scritta quando i sistemi AI erano soprattutto chatbot e classificatori. Nel 2026, l’AI aziendale significa sempre più agenti.
Gli agenti differiscono dai chatbot in un aspetto operativo importante: compiono azioni. Un agente con accesso agli strumenti per e-mail, database interni, file system, browser ed esecuzione di codice non è un chatbot con più funzionalità. È un processo autonomo con accesso significativo a sistemi reali, che opera in base agli output di un modello linguistico.
OWASP mantiene ora un Agentic AI Top 10 separato, perché il modello di minaccia degli agenti differisce abbastanza dalle applicazioni di chat LLM da richiedere una documentazione distinta.
Nel contesto di un agente, prompt injection non produce una risposta testuale indesiderata. Produce un’azione indesiderata. Un’iniezione indiretta in un documento recuperato può ordinare all’agente di eliminare file, esfiltrare dati o inviare e-mail. La conseguenza non è una risposta inappropriata, ma un’azione non autorizzata contro i sistemi a cui l’agente può accedere.
La superficie di attacco degli agenti include:
- Limiti di invocazione degli strumenti: se l’agente è limitato agli strumenti minimi adatti a ogni attività
- Ambito delle credenziali: se le credenziali dell’agente sono limitate a ciò che richiede ogni attività
- Reversibilità delle azioni: se le azioni importanti richiedono approvazione umana prima dell’esecuzione
- Filtraggio degli output: se gli output dell’agente sono convalidati prima di attivare azioni successive
- Isolamento: se l’ambiente di esecuzione impedisce accessi involontari ai sistemi collegati
La maggior parte delle certificazioni di governance AI non copre la progettazione della sicurezza degli agenti con questo livello di specificità.
Model Context Protocol crea una nuova superficie di attacco aziendale
Model Context Protocol (MCP) è diventato uno standard ampiamente adottato per collegare agenti AI a strumenti, fonti di dati e servizi esterni. I server MCP espongono capacità che gli agenti individuano e usano. L’integrazione è rapida e flessibile, ma le implicazioni per la sicurezza non ricevono sempre pari attenzione.
I rischi specifici di MCP includono:
- Server MCP malevoli che descrivono in modo falso le proprie capacità ed eseguono azioni indesiderate
- Avvelenamento degli strumenti, in cui un server MCP legittimo restituisce dati controllati dall’aggressore e inserisce istruzioni in output che dovrebbero contenere dati
- Strumenti con privilegi eccessivi, quando le integrazioni MCP hanno permessi oltre le necessità dell’attività
- Confusione dei confini di fiducia, quando l’agente tratta le istruzioni degli strumenti MCP collegati come istruzioni dell’utente
Le organizzazioni che distribuiscono agenti con integrazioni MCP hanno bisogno di un framework per valutare l’affidabilità dei server MCP, verificare i permessi degli strumenti e controllare che le risposte degli strumenti siano trattate come dati, non come istruzioni.
La valutazione è la pratica operativa che le certificazioni saltano
Il red teaming AI e le suite di valutazione stanno sostituendo le valutazioni statiche di sicurezza come metodi principali per comprendere i rischi dei modelli prima e dopo la distribuzione.
Il red teaming AI comprende:
- Test avversari strutturati del comportamento del modello contro tecniche di attacco note
- Benchmark di jailbreak con dataset consolidati di attacchi tramite prompt
- Test di robustezza avversaria che misurano le variazioni dell’output con input perturbati
- Test di regressione comportamentale tra versioni del modello
- Valutazione dei benchmark di sicurezza con suite pubblicate
NIST, Anthropic, OpenAI, Microsoft, Google e CISA raccomandano red teaming specifico per l’AI prima di distribuire sistemi ad alto rischio. Sta diventando un’aspettativa standard, non una pratica facoltativa.
Nessuna delle certificazioni attuali di governance AI prepara adeguatamente i professionisti a definire l’ambito, eseguire o interpretare un esercizio di red teaming su un modello o agente distribuito. Descrivono cos’è il red teaming, ma non insegnano a svolgerlo.
L’osservabilità AI è una disciplina distinta
La registrazione tradizionale degli eventi di sicurezza non si trasferisce direttamente ai sistemi AI. Monitorare un LLM o un agente in produzione richiede la raccolta e l’analisi di dati diversi.
L’infrastruttura di osservabilità AI comprende:
- Telemetria di prompt e output per rilevare anomalie e identificare violazioni delle policy
- Log delle invocazioni degli strumenti degli agenti, compresi strumenti chiamati e argomenti usati
- Monitoraggio della qualità del recupero nelle pipeline RAG
- Rilevamento e classificazione dei tentativi di jailbreak
- Monitoraggio della coerenza degli output per identificare drift tra versioni del modello
- Monitoraggio della frequenza di allucinazioni nelle applicazioni in cui conta la precisione fattuale
- Pattern di latenza che possono indicare tentativi di prompt injection per aumentare la dimensione del contesto
È una disciplina emergente. Nel 2026 la maggior parte delle organizzazioni che distribuisce AI ha molta meno osservabilità dei componenti AI rispetto all’infrastruttura tradizionale. La maggior parte delle certificazioni di governance non descrive l’osservabilità adeguata per i sistemi AI.
La risposta agli incidenti AI non è come l’IR tradizionale
Quando un sistema tradizionale viene compromesso, il playbook IR copre contenimento, analisi forense e ripristino. Gli incidenti AI sollevano domande che il playbook standard non affronta.
Prepara procedure per queste domande prima di averne bisogno:
- Come determinare se un modello è stato avvelenato durante il fine-tuning
- Come valutare se un recupero RAG è stato abusato per restituire contenuti controllati dall’aggressore
- Come identificare se un agente ha eseguito azioni non autorizzate e quale fosse la loro portata
- Come verificare se un aggiornamento del modello di un fornitore terzo ha cambiato il comportamento in modi rilevanti per la sicurezza
- Come stabilire il comportamento del modello prima di un incidente per confrontarlo con quello successivo
Questi temi richiedono preparazione prima dell’incidente, log e telemetria configurati in anticipo e runbook specifici per l’AI che includano l’analisi forense del comportamento del modello, non solo il traffico di rete e i log degli endpoint.
Il problema dell’aggiornamento delle certificazioni
Una ragione strutturale per cui le certificazioni restano indietro è che la sicurezza AI cambia più rapidamente dei cicli di aggiornamento.
Security+, CISSP e ISO 27001 coprono ambiti che evolvono nel corso degli anni. Le superfici principali di attacco di reti, endpoint e applicazioni sono relativamente stabili. Le tecniche di attacco all’AI evolvono in pochi mesi. Nel 2026, le tecniche di prompt injection, i metodi di attacco avversario e le superfici di attacco degli agenti sono diverse da quelle esistenti al lancio delle prime certificazioni AI, nel 2023 e 2024.
Gli enti di certificazione aggiornano i materiali secondo programmi definiti. OWASP LLM Top 10 ha pubblicato una revisione importante nel suo primo anno. MCP non era ancora una questione aziendale quando furono progettate molte certificazioni AI attuali. I framework per la sicurezza dell’AI agentica sono successivi alla maggior parte dei curricula attuali.
È un problema strutturale, non una mancanza di intenti. Leggi continuamente le fonti primarie invece di trattare una certificazione come un patrimonio fisso di conoscenze.
Cosa devono includere le certificazioni di sicurezza AI
Per riflettere la pratica attuale della sicurezza AI, i curricula di certificazione devono coprire:
- Difesa in profondità contro prompt injection: filtraggio degli input, validazione degli output, limitazione degli strumenti, isolamento e approvazione umana, insieme ai limiti documentati di ciascuna misura
- Verifica della catena di fornitura dei modelli: rischi della serializzazione non sicura, requisiti SBOM, documentazione della provenienza e verifica degli artefatti firmati
- Architettura di sicurezza degli agenti AI: confini di fiducia, accesso minimo agli strumenti, reversibilità delle azioni e requisiti di monitoraggio
- Sicurezza MCP e delle integrazioni esterne: valutazione della fiducia nei server degli strumenti, audit dei permessi e separazione tra dati e istruzioni
- Valutazione e red teaming: come definire l’ambito di una valutazione avversaria, quali benchmark e dataset esistono e come interpretare i risultati
- Osservabilità AI: log e telemetria necessari e loro uso per rilevare e rispondere agli incidenti
- Risposta agli incidenti specifica per l’AI: pianificazione preventiva degli scenari, raccolta di prove sul comportamento del modello e considerazioni di ripristino specifiche
- Prevenzione delle fughe di dati: isolamento RAG, riservatezza dei prompt, controlli di accesso multi-tenant e filtraggio degli output
Cosa fare subito
Se sei responsabile dei sistemi AI nella tua organizzazione:
Leggi OWASP Top 10 for Large Language Model Applications e OWASP Agentic AI Top 10. Sono gratuiti e più specifici sul piano operativo dei programmi di certificazione a pagamento disponibili oggi.
Esamina MITRE ATLAS prima della prossima sessione di threat modeling su un componente AI. Scopri quali tattiche avversarie si applicano alla tua architettura prima di finalizzare il progetto di distribuzione.
Leggi NIST AI 600-1. Estende il framework AI RMF di base specificamente all’AI generativa ed è molto più pertinente alle distribuzioni LLM e agli agenti rispetto al solo framework di base.
Consulta Google SAIF, Microsoft’s AI SDL e OWASP AI Exchange per le indicazioni ingegneristiche che i framework di governance non forniscono.
Verifica la provenienza di ogni modello distribuito dalla tua organizzazione. Controlla le schede dei modelli. Prima di caricare i pesi, analizza i formati di serializzazione alla ricerca di classi di exploit note.
Mappa ogni agente AI nel tuo ambiente in base agli accessi che possiede. Un agente con accesso di lettura e scrittura alla knowledge base interna, alla posta elettronica e al file system amplifica l’impatto di prompt injection. Limita le credenziali a ciò che serve per ogni attività.
Richiedi red teaming specifico per l’AI prima di distribuire modelli o agenti in contesti ad alto impatto. Rendilo obbligatorio.
Prepara ora runbook di risposta agli incidenti specifici per l’AI, prima di averne bisogno.
Considera la certificazione di governance come documentazione del livello di processo. Non documenta il tuo livello di sicurezza.
Riferimenti
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation

Related Posts