2x RTX 5060 Ti contro GB10: perché 32 GB di VRAM perdono contro 128 GB di memoria unificata
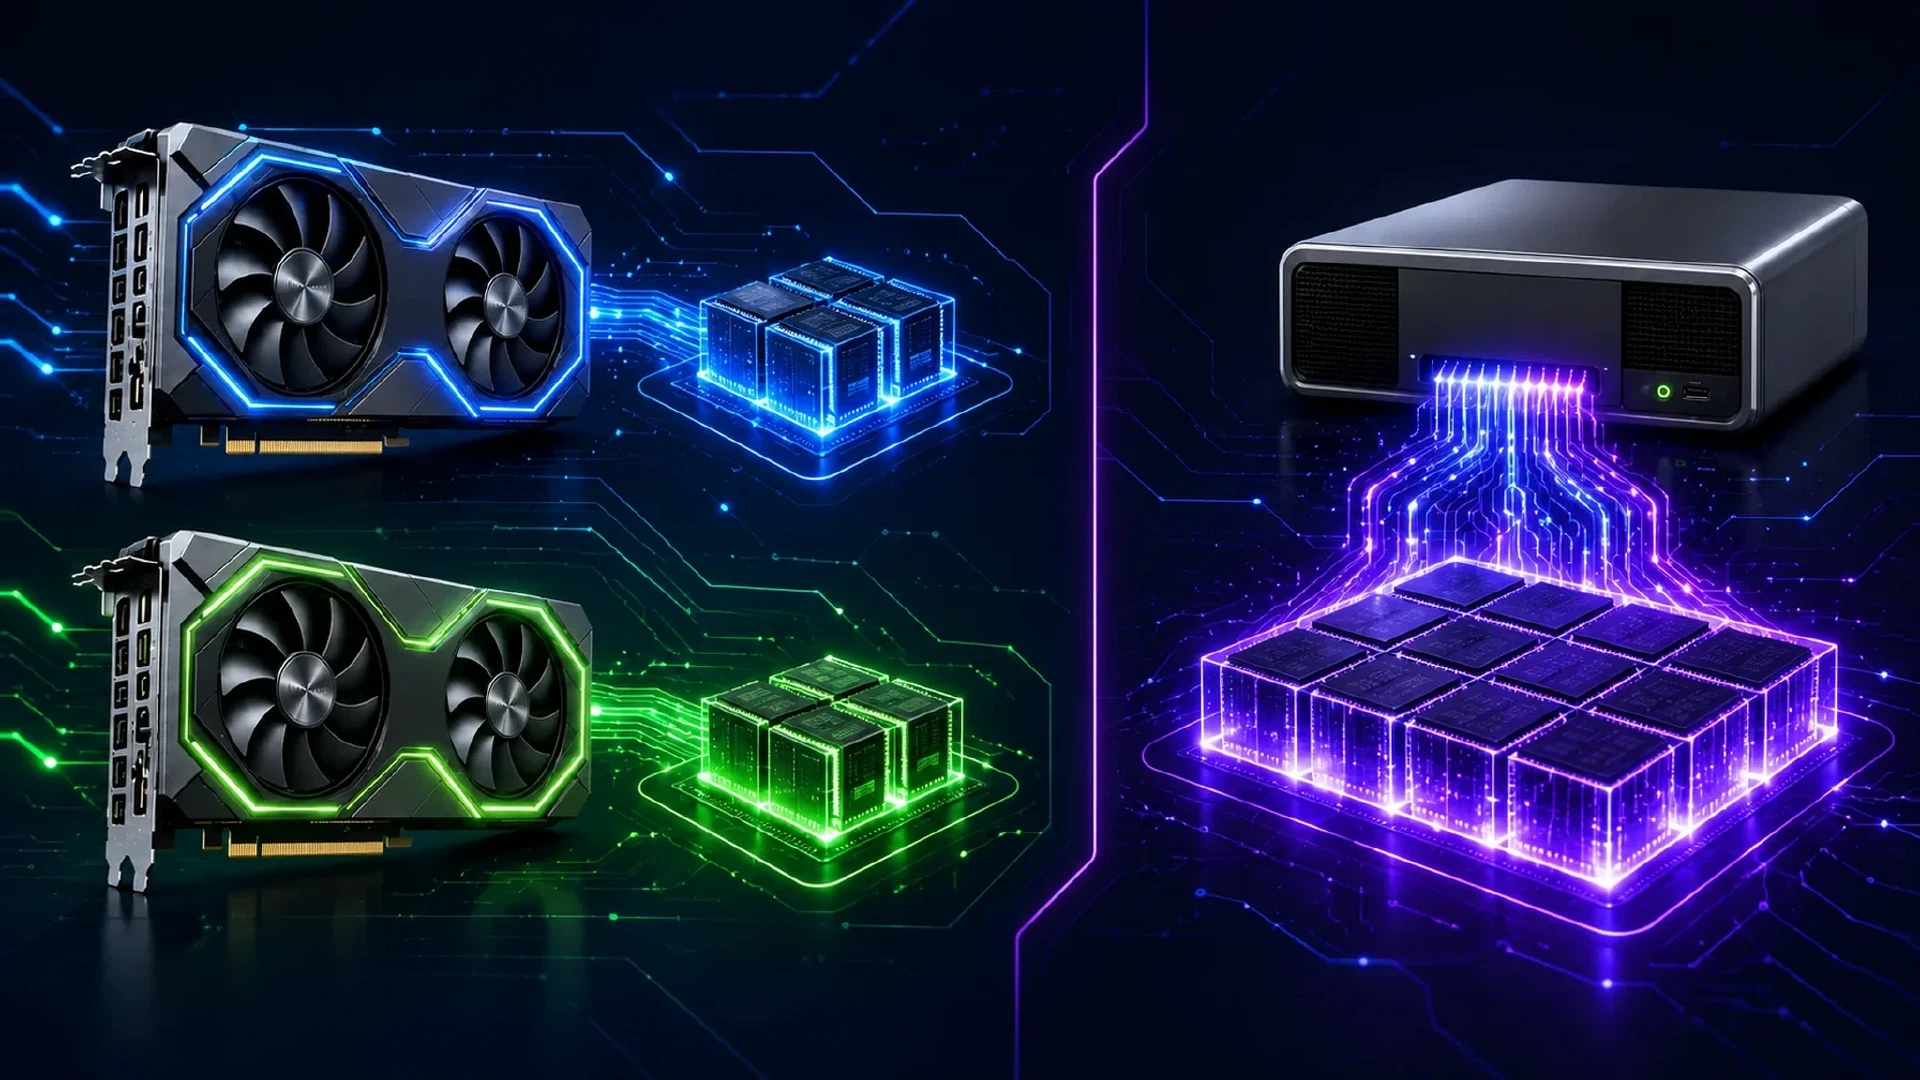
Table of Contents
Due schede RTX 5060 Ti da 16 GB sembrano interessanti in una lista componenti. Offrono 32 GB di VRAM complessiva e una buona elaborazione dei prompt con contesto breve. Il confronto cambia quando esegui un modello 27B con contesto lungo.
Il sistema NVIDIA GB10 usa 128 GB di memoria unificata coerente. NVIDIA indica per la piattaforma GB10 128 GB di memoria unificata LPDDR5x e un TDP del chip di 140 W. La RTX 5060 Ti usa 16 GB di GDDR7 per scheda, un’interfaccia di memoria a 128 bit e una potenza grafica totale di 180 W. Le specifiche NVIDIA RTX 5060 Ti e le specifiche NVIDIA GB10 rendono chiara la differenza hardware.
Il punto è semplice. Due schede da 16 GB non creano un unico pool di memoria veloce da 32 GB. Creano due pool separati da 16 GB collegati attraverso il sistema host. Nell’inferenza di modelli grandi, la capacità mancante e il movimento dei dati tra dispositivi contano più del numero di schede.
Confronto della memoria
| Sistema | Memoria | Modello di memoria | Potenza indicata |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB complessivi | Due pool separati di memoria GPU | 360 W GPU totali |
| Sistema GB10 | 128 GB | Memoria di sistema unificata coerente | TDP GB10 di 140 W |
Il GB10 non vince perché 128 GB di memoria LPDDR5x eguagliano la larghezza di banda di una GPU discreta di fascia alta. Il vantaggio nasce da capacità e collocazione. CPU e GPU condividono lo stesso spazio degli indirizzi. Modello, buffer del runtime, attivazioni e dati del contesto non devono quindi entrare in due dispositivi isolati da 16 GB.
Il sistema a due schede affronta un problema di collocazione più difficile. Il modello deve stare su entrambe le schede. Il runtime di inferenza deve spostare dati tra loro. Il traffico PCIe aggiunge latenza e consuma banda. Inoltre, secondo le specifiche NVIDIA, la RTX 5060 Ti non supporta NVLink.
Risultato del benchmark
I risultati seguenti provengono dal rapporto di benchmark IA fornito. Il rapporto confronta un sistema dual-GPU senza nome, indicato come 5060ti-x2, con un sistema GB10. Il test copre Qwen e GPT-OSS a diverse dimensioni di contesto.
I modelli provenivano direttamente da Ollama. Il test usava i tag predefiniti letterali qwen3.8:27b e gpt-oss:latest, senza Modelfile personalizzato né quantizzazione alternativa. Il sistema 5060ti-x2 usava PCIe Gen4 x16 e i driver NVIDIA Linux più recenti disponibili durante il benchmark.
Elaborazione dei prompt e generazione con Qwen
| Contesto | Prompt 5060ti-x2 tok/s | Generazione 5060ti-x2 tok/s | Prompt GB10 tok/s | Generazione GB10 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
A 4K, il sistema a due schede genera circa il doppio più velocemente del GB10. A 64K, il vantaggio scende a circa 1,5 volte. A 128K, i sistemi raggiungono una velocità di generazione quasi uguale.
A 256K, il confronto non appare più come una vittoria della configurazione a due schede. La richiesta 5060ti-x2 ha raggiunto solo 171.359 token di prompt effettivi. La generazione è scesa a 1,2 token al secondo. Il GB10 ha completato il test completo a 256K con 25,8 token al secondo.
Nel risultato testato a 256K, il GB10 ha generato circa 21,5 volte più velocemente. Ancora più importante, il GB10 ha completato il contesto richiesto. Il sistema dual-GPU non ha fornito lo stesso carico di lavoro.
Perché la VRAM complessiva è fuorviante
1. Il modello non vede una scheda da 32 GB
Due GPU non fondono la memoria in un unico spazio degli indirizzi locale. Un runtime model-parallel divide livelli o tensori tra i dispositivi. Ogni dispositivo deve comunque conservare spazio per i propri pesi, i buffer temporanei e una parte dello stato del contesto.
La capacità utilizzabile è quindi inferiore alla semplice somma. L’overhead esatto dipende dal formato del modello, dalla quantizzazione, dal backend di inferenza, dalla divisione dei tensori e dalla lunghezza del contesto.
2. La memoria del contesto cresce durante la generazione
I pesi del modello sono solo una parte del budget di memoria. La cache key-value, o cache KV, conserva i dati di attenzione dei token precedenti. I contesti più lunghi richiedono più memoria per la cache. Un test a 4K non predice un deployment a 128K o 256K.
I risultati forniti mostrano bene questo limite. Il sistema a due schede mantiene un forte vantaggio nell’elaborazione dei prompt, poi perde prestazioni di generazione quando il contesto cresce. Il GB10 resta vicino a 26-29 token generati al secondo da 4K a 256K.
3. I trasferimenti PCIe aggiungono un costo
Quando il runtime sposta attivazioni o tensori tra GPU, il trasferimento attraversa l’interconnessione host. Questo crea punti di sincronizzazione e aggiunge latenza a ogni passaggio. Il costo cresce quando il carico supera ripetutamente il confine tra dispositivi.
Questo non rende inutile un sistema dual-GPU. La collocazione della memoria contribuisce al risultato delle prestazioni. Un benchmark che riporta solo l’elaborazione dei prompt a 4K perde questo costo.
4. L’efficienza energetica è un vantaggio del sistema
Nel confronto il GB10 usa meno energia e offre più capacità di memoria per il carico a contesto lungo testato. Due RTX 5060 Ti hanno una potenza GPU complessiva di 360 W prima del resto del sistema. NVIDIA indica un TDP GB10 di 140 W.
Il GB10 scambia la velocità massima con contesto breve per capacità, completamento e minore potenza GPU. Per l’inferenza Qwen a contesto lungo, questi compromessi contano.
Il sistema 5060ti-x2 costa molto meno
Il confronto delle prestazioni non annulla la differenza di prezzo. Una workstation completa con due RTX 5060 Ti da 16 GB era quotata $3.479 il 10 ottobre 2026. La configurazione comprende Intel Ultra 7 265K, scheda madre Z890, 32 GB DDR5, 1 TB di storage, alimentatore da 1.000 W e entrambe le GPU. Vedi la workstation completa dual-GPU .
Il marketplace statunitense NVIDIA elenca il DGX Spark da 128 GB a $6.950. L’offerta include 128 GB di memoria unificata coerente e 4 TB di storage NVMe, ma il sistema risulta esaurito. Controlla l’offerta attuale NVIDIA DGX Spark .
La AMD Ryzen AI Halo Developer Platform offre un altro punto di confronto. Questo sistema Strix Halo costa $3.999,99 da Micro Center, con 128 GB di memoria unificata LPDDR5x e 2 TB di storage. Strix Halo spesso rientra nella stessa categoria pratica di IA locale dei sistemi GB10, anche se i test indipendenti misurano spesso il GB10 avanti per throughput e maturità software. Controlla l’offerta Linux attuale di Micro Center e leggi la recensione Strix Halo contro GB10 .
| Sistema completo | Prezzo indicato il 10 ottobre 2026 | Differenza di prezzo |
|---|---|---|
| Workstation 5060ti-x2 | $3,479 | Base |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 in più |
| DGX Spark GB10 da 128 GB | $6,950 | $3,471 in più |
Il GB10 offre un pool di memoria unificata più grande, consumi inferiori e un’architettura migliore per i contesti lunghi. Il sistema AMD offre la stessa classe di memoria da 128 GB per circa $4.000. La workstation 5060ti-x2 resta circa al 50% del prezzo indicato del GB10, prima di tasse e spedizione. Chi ha bisogno di memoria unificata ma non dello stack software NVIDIA trova in Strix Halo un’alternativa meno costosa.
Questi sono prezzi indicati da venditori diversi, non un paniere retail controllato. Il confronto lascia inoltre il sistema 5060ti-x2 con meno memoria di sistema e storage. La differenza conta perché entrambe le offerte descrivono computer completi e utilizzabili, non prezzi di GPU nude. Le schede RTX 5060 Ti da 16 GB sono ora vicine a $789-$830 ciascuna, molto sopra il prezzo di lancio di $429. Il vantaggio di prezzo del sistema a due schede resta quindi anche durante l’attuale aumento dei prezzi delle GPU. Controlla i prezzi attuali RTX 5060 Ti .
Il risultato GPT-OSS richiede un trattamento separato
Lo stesso rapporto mostra buoni risultati di generazione 5060ti-x2 per GPT-OSS da 4K a 256K. Il GB10 completa i test da 4K a 128K, ma il test GPT-OSS a 256K è indicato come non supportato.
Non usare la tabella GPT-OSS per dichiarare un vincitore universale. I test non coprono la stessa estensione a 256K. Il risultato Qwen offre il confronto più chiaro per il contesto lungo perché entrambi i sistemi riportano un risultato a 256K, anche se l’esecuzione 5060ti-x2 ha raggiunto solo 171.359 token di prompt effettivi.
Cosa significa per una configurazione Qwen 3 27B
Una configurazione con due schede da 16 GB potrebbe eseguire un modello 27B quantizzato con un contesto più piccolo. Il benchmark non smentisce questo caso d’uso. I dati smentiscono l’affermazione secondo cui 32 GB di VRAM complessiva offrano la stessa margine pratica di un sistema con 128 GB di memoria unificata.
Far entrare un modello in una scheda dimostra solo la capacità per i pesi. Il requisito reale comprende pesi, contesto attivo, cache KV, buffer del runtime e margine per il sistema operativo. Il contesto deve stare accanto al modello. Un modello che si carica ma non lascia spazio alla conversazione di lavoro non è una configurazione a contesto lungo utilizzabile.
Questo corrisponde alle indicazioni di dimensionamento in 16 GB di VRAM bastano per un lavoro serio con LLM locali? , che trattano pesi, contesto e allocazioni del runtime come un unico budget. La guida ai 32 GB di VRAM per Qwen 27B arriva alla stessa conclusione per le configurazioni a due schede. La capacità complessiva non equivale al margine utilizzabile.
Prima di acquistare hardware per Qwen 3 27B, poni quattro domande:
- La quantizzazione richiesta entra insieme ai buffer del runtime? I soli pesi non definiscono il requisito di memoria.
- Il contesto entra senza forte pressione sulla cache KV? I prompt lunghi cambiano il risultato.
- Il runtime usa una divisione veloce tra dispositivi? I trasferimenti PCIe e la collocazione dei tensori influenzano ogni token generato.
- Il sistema completa il contesto obiettivo? Un risultato rapido a 4K non compensa un carico 256K fallito.
Il test fornito risponde all’ultima domanda per il sistema a due schede. L’esecuzione ha raggiunto 171.359 token durante la richiesta Qwen a 256K e ha generato 1,2 token al secondo. Il GB10 ha completato 256K a 25,8 token al secondo.
Per questo carico a contesto lungo, la memoria unificata è l’architettura migliore quando l’alternativa usa PCIe per coprire il working set del modello. PCIe resta una soluzione di capacità. PCIe non crea lo stesso pool di memoria, la stessa latenza o lo stesso percorso di trasferimento. La guida al contesto GPU per IA locale spiega perché pesi, cache KV, output degli strumenti e buffer del runtime devono essere dimensionati insieme. Il benchmark GPU Qwen3.8 27B con Ollama mostra anche perché i risultati a contesto lungo richiedono attenzione separata dai numeri di decode a contesto breve.
Verdetto
Due schede RTX 5060 Ti da 16 GB sono un sostituto scarso del GB10 quando l’obiettivo è l’inferenza 27B a contesto lungo. Offrono un throughput dei prompt maggiore con contesti brevi. Usano anche più potenza GPU ed espongono il runtime a una memoria divisa.
Nei risultati forniti il GB10 è più lento nell’elaborazione dei prompt. Il sistema è più efficiente, offre quattro volte la memoria complessiva e completa il test Qwen a 256K con una velocità di generazione utilizzabile.
Se esegui prompt brevi e dai valore all’ingestione dei prompt, 5060ti-x2 ha un caso limitato. Per un modello 27B, il pool di memoria unificata più grande è la scelta migliore perché modello e contesto condividono lo stesso working set coerente. La memoria unificata resta preferibile quando i trasferimenti PCIe entrano nel percorso di inferenza.
Il benchmark non mostra che due RTX 5060 Ti non avvieranno mai Qwen 3 27B. I dati mostrano perché avviare il modello è diverso dall’eseguire bene il carico di lavoro.
Limiti del benchmark
Il rapporto fornito identifica i tag Ollama letterali, ma non registra i digest dei manifest risolti, le revisioni dei modelli, la CPU, le misure di potenza o la configurazione di raffreddamento. Identifica anche PCIe Gen4 x16 per il sistema 5060ti-x2 e i driver NVIDIA Linux correnti al momento del test. Considera i numeri un confronto osservato tra sistemi, non una classifica universale di ogni coppia RTX 5060 Ti e ogni implementazione GB10.
Le specifiche hardware sopra vengono da NVIDIA. I dati sulle prestazioni provengono dal benchmark fornito per questo articolo.
Riferimenti
- Libreria modelli Ollama Qwen3.8
- Tag modelli Ollama GPT-OSS
- 16 GB di VRAM bastano per un lavoro serio con LLM locali?
- 32 GB di VRAM per Qwen 27B
- Guida al contesto GPU per IA locale
- Benchmark GPU Qwen3.8 27B su Vast.ai
- Workstation completa con due RTX 5060 Ti da 16 GB
- Offerta NVIDIA DGX Spark sul marketplace USA
- Offerta Linux AMD Ryzen AI Halo da 128 GB
- Recensione Tom’s Hardware di Strix Halo contro GB10
- Prezzi attuali RTX 5060 Ti
Related Posts